这是《智能体进研发流程》系列第四篇。第一篇 讲入口怎么放开,第二篇 讲闸门怎么建,第三篇 讲什么该当资产。这一篇讲一次纠正该存放在哪里。
一个绕过办法被写进代码,旁边留了一行注释解释它为什么这样写。几天到几周之后,这个绕过办法连同那行注释,成了整个仓库事实上的标准写法。复制它的是下一个会话里的智能体。
智能体纠错问的是同一件事:同一类错误第二次出现之前,你把上一次的纠正放在了哪里。下面这套落点顺序来自一位在 Cursor 做编程智能体的工程师 2026 年 9 月至 10 月的公开演讲与访谈,同样适用于把智能体接进业务系统的团队。
数字的出处先交代。她 9 月 21 日的帖文写的是上个月把 2,500 个 PR 送进生产环境;10 月 2 日访谈的口播说的是大约 2,000 个。两个数出自不同场合,本文不合并。这些数量是她的自述,含大量维护、重构和代码整理,没有可独立核对的清单或缺陷率。
模型接着写的是仓库里的样子
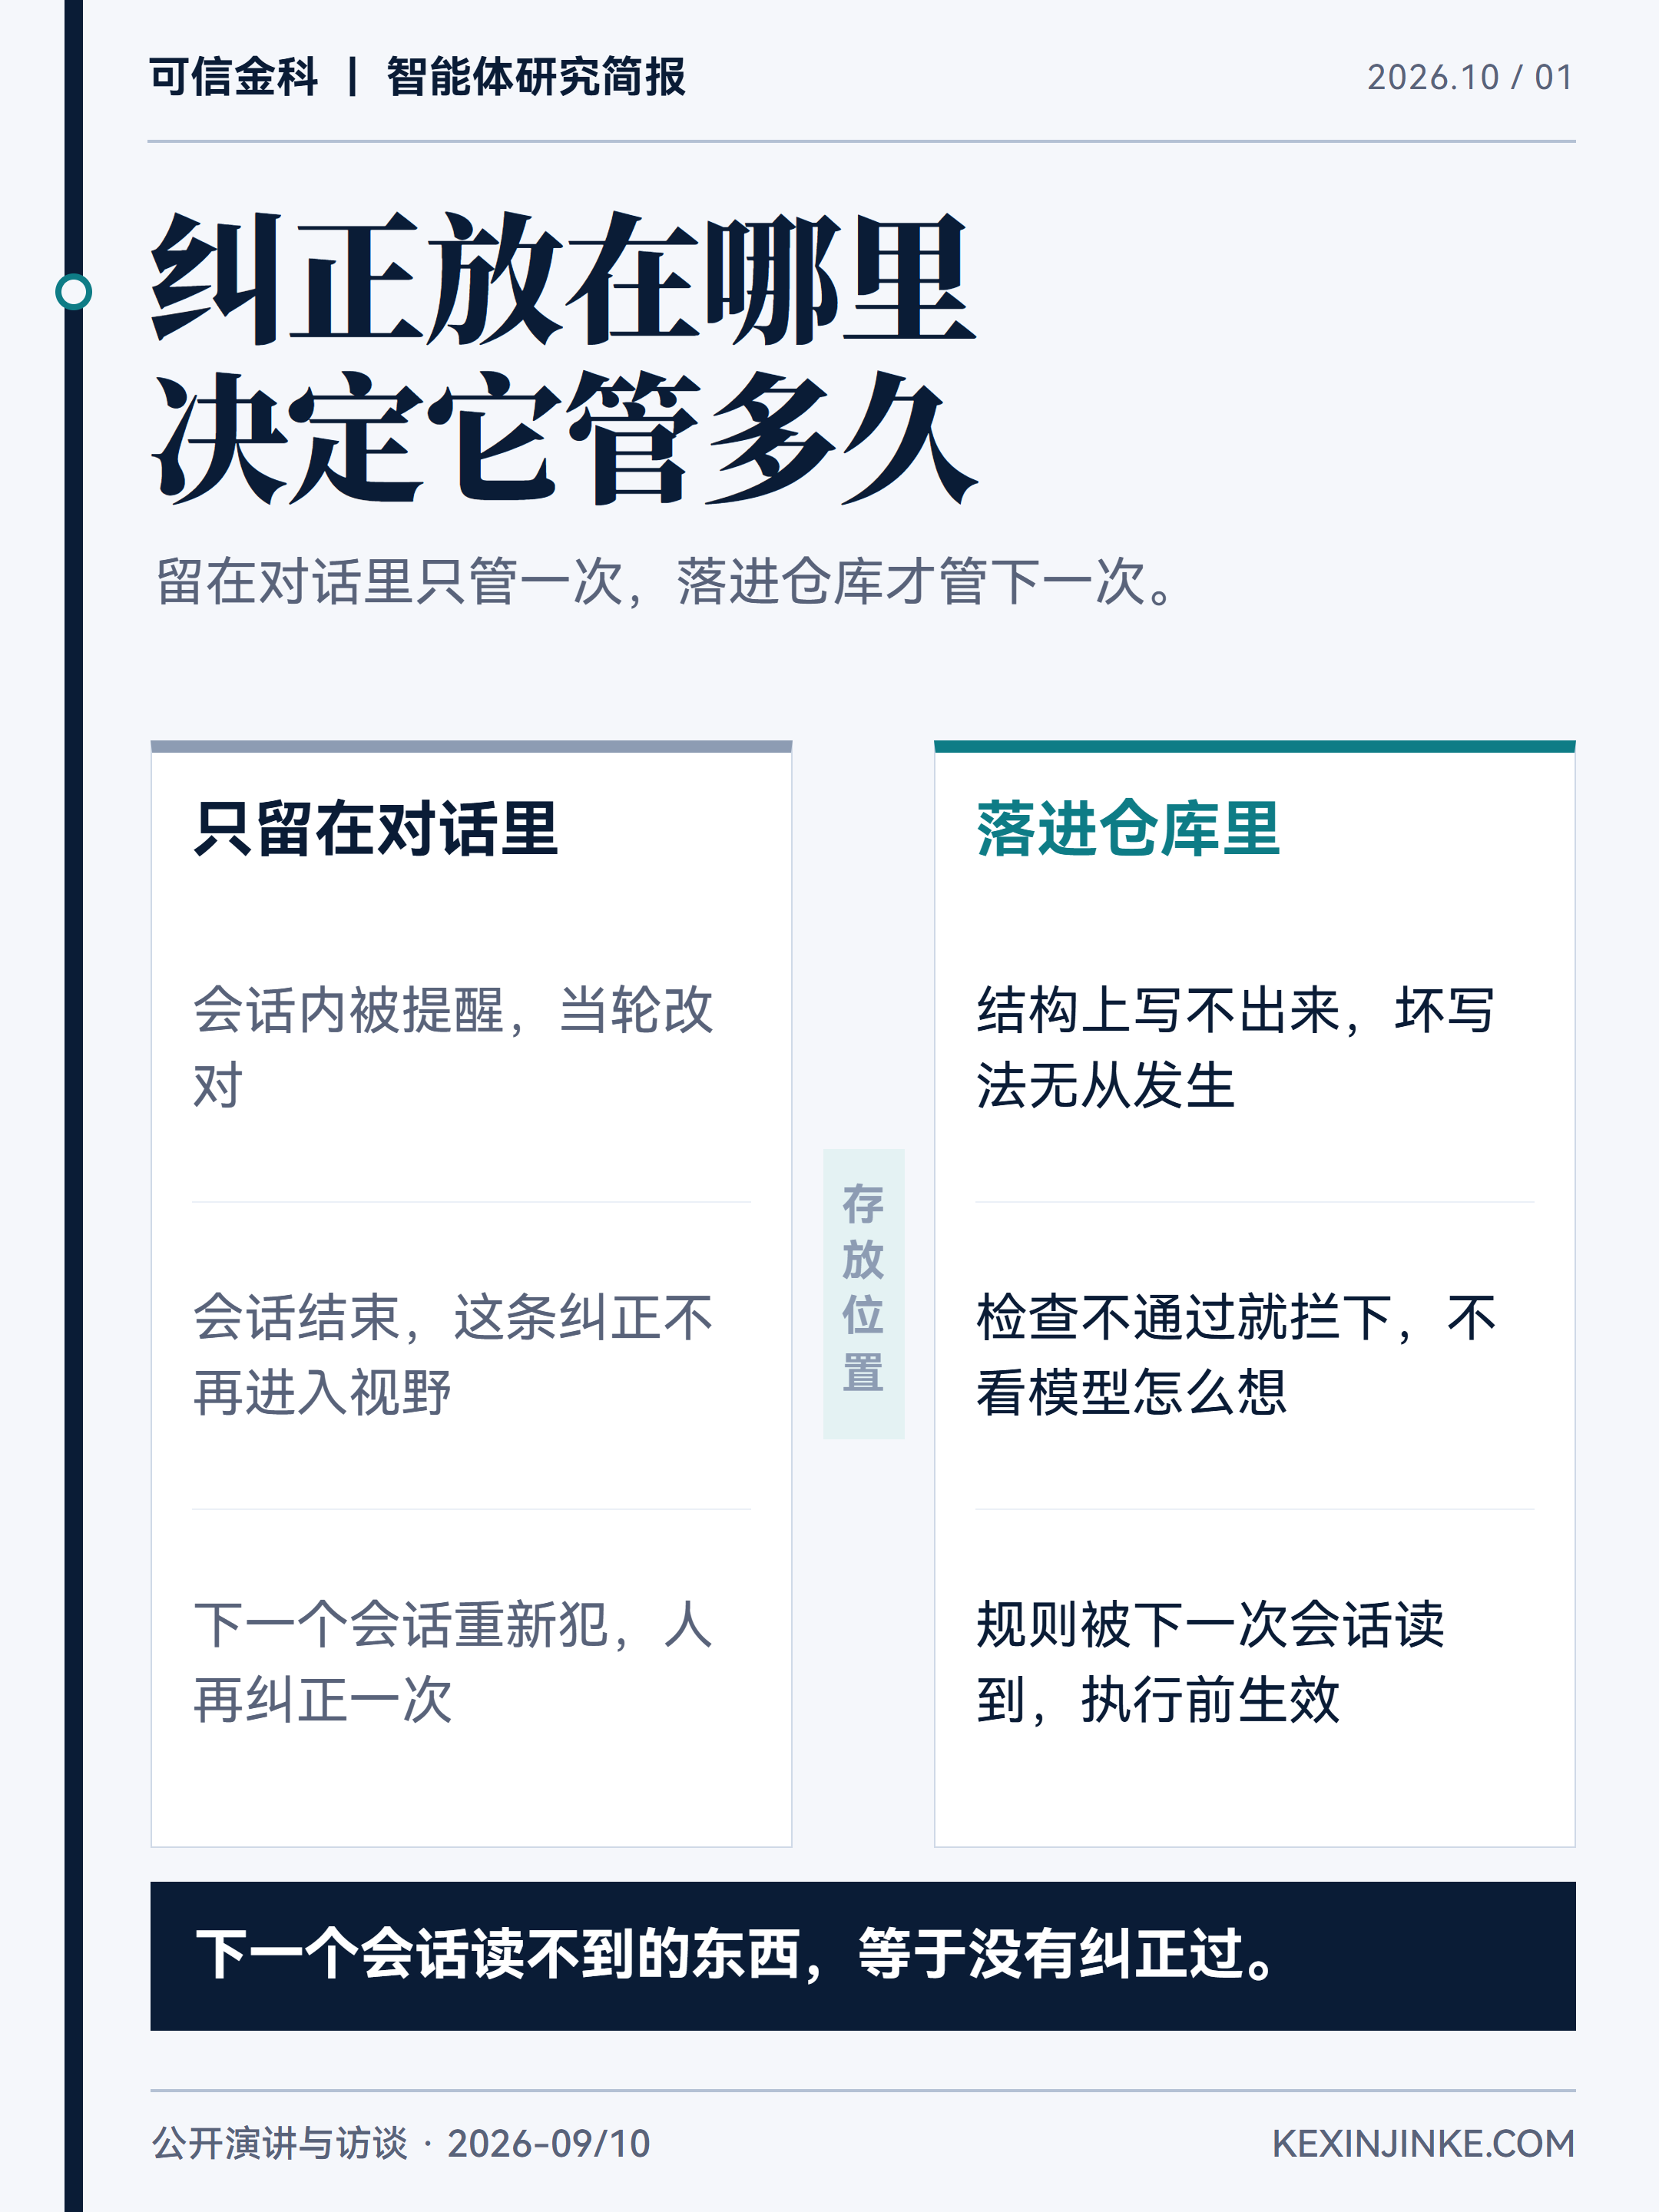
模型沿用上下文里已有的内容。它读过、打开过的文件就在上下文里,于是它接着写,不会先把旧代码重构一遍。仓库里留下的样子,因此比一次对话里的叮嘱耐久得多。
纠正只停在对话里,下一个会话看不到;纠正变成"这种写法写不出来"或者"检查会失败",下一个会话也躲不开。她回忆团队早期的编程智能体由 8 个巨型文件组成,每个至少一万行,后来按功能拆成目录,原因就在这里。
反过来的效应同样成立。一个小绕过办法,或者一段解释这个绕过的注释,几天到几周就会被复制成标准写法。她把这种扩散比成病毒:你希望被复制的状态,必须是你自己也愿意让下一个智能体照抄的状态。
一次纠正能落在哪几层
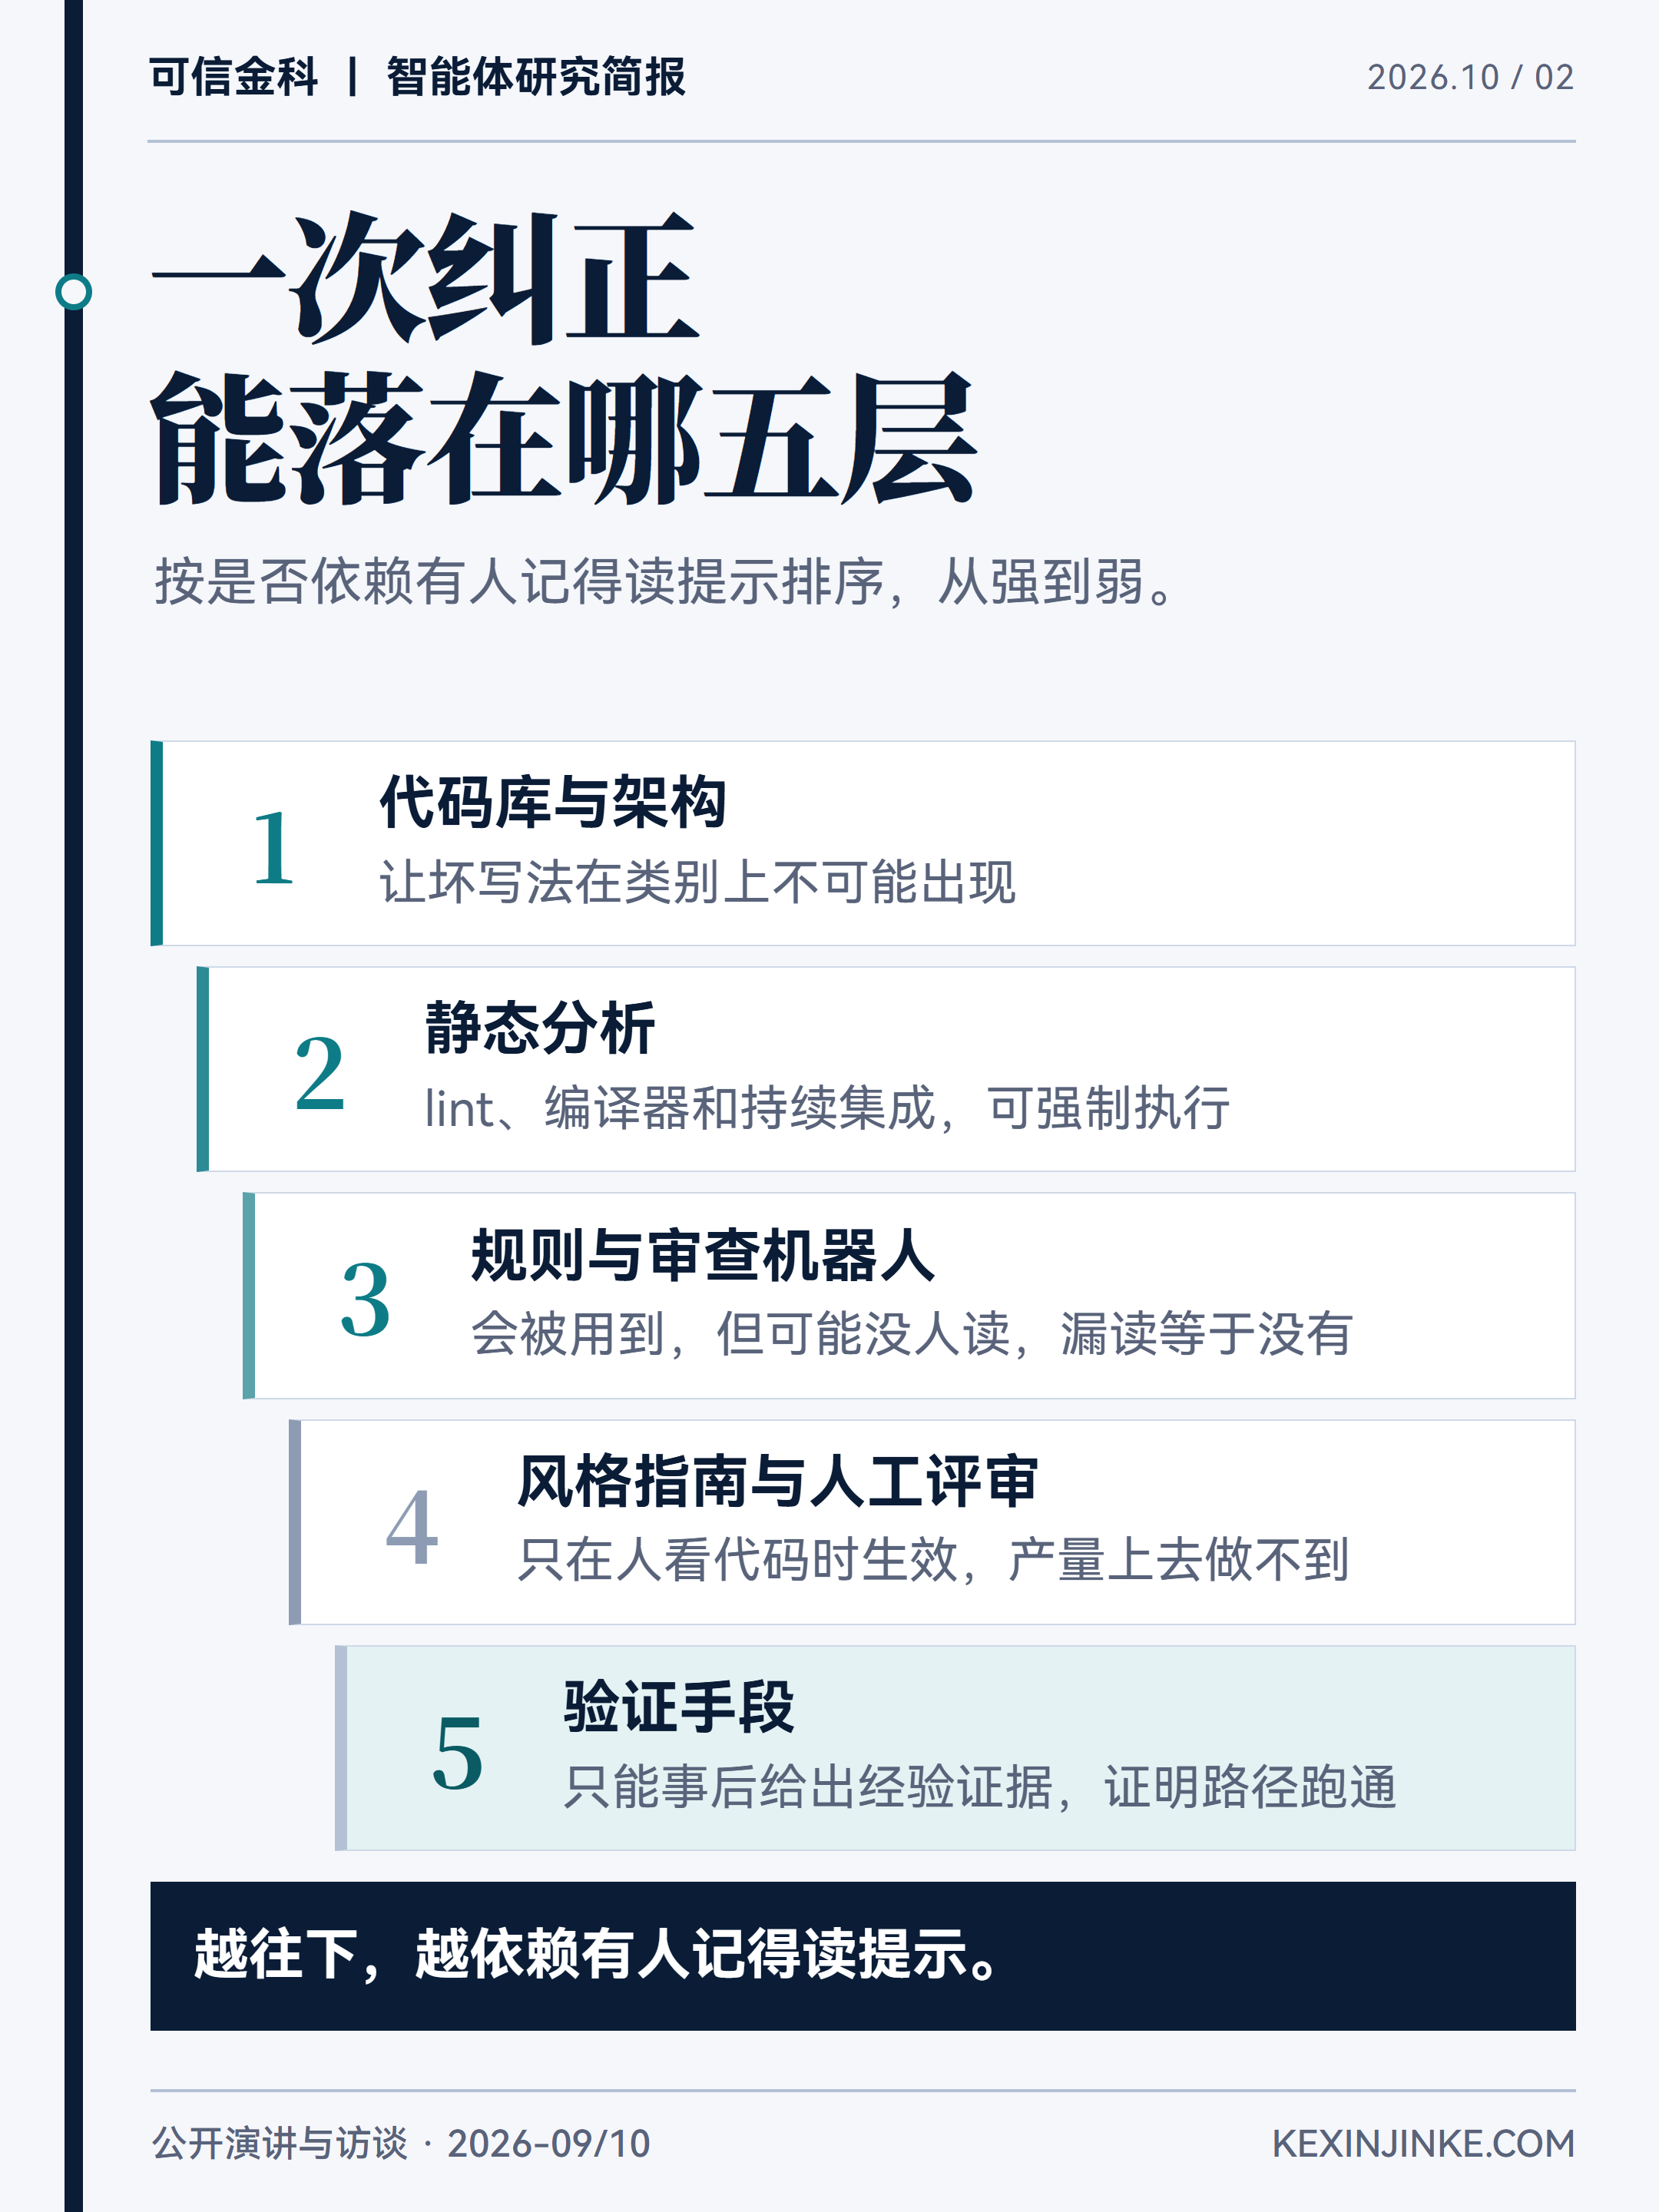
她按"是否依赖某一次对话里有人记得去读一段提示"排序,从强到弱列出五层。这五层按作用分成三组。
最靠前的两层能让坏写法根本写不出来。第一层是代码库与架构,改的是数据结构和做法本身;第二层是静态分析,lint、编译器和持续集成都能在仓库里强制执行,不依赖任何人记得去读一段说明。
第三层和第四层性质变了,只能让智能体少写错。规则和审查机器人多数时候会被用到,但智能体可能忘了读,开着它的人也可能不理;漏读一次,约束等于没有发生。再往后是风格指南和人工评审,没写进规则或检查的风格指南,只在人看代码时生效,产量上去之后这做不到。
最后一层是验证手段,只能事后证明。它拿出的是经验证据,例如某条路径跑通了。
再往前一步是形式化方法,用 Lean 或 TLA+ 检查业务不变量是否恒成立。她承认自己没走这条路,也说形式化至今仍然难。这是边界:验证手段覆盖不了形式化要证的不变量。
评审里反复出现的同一句话,是这一层还没建好的信号
发现智能体写错,最直接的反应是把提示词改长,加一句"请认真核对"。如果当时缺的是一份能核对的资料,或者一条能拦住它的检查,这句话只是把同类错误推迟到下一次。
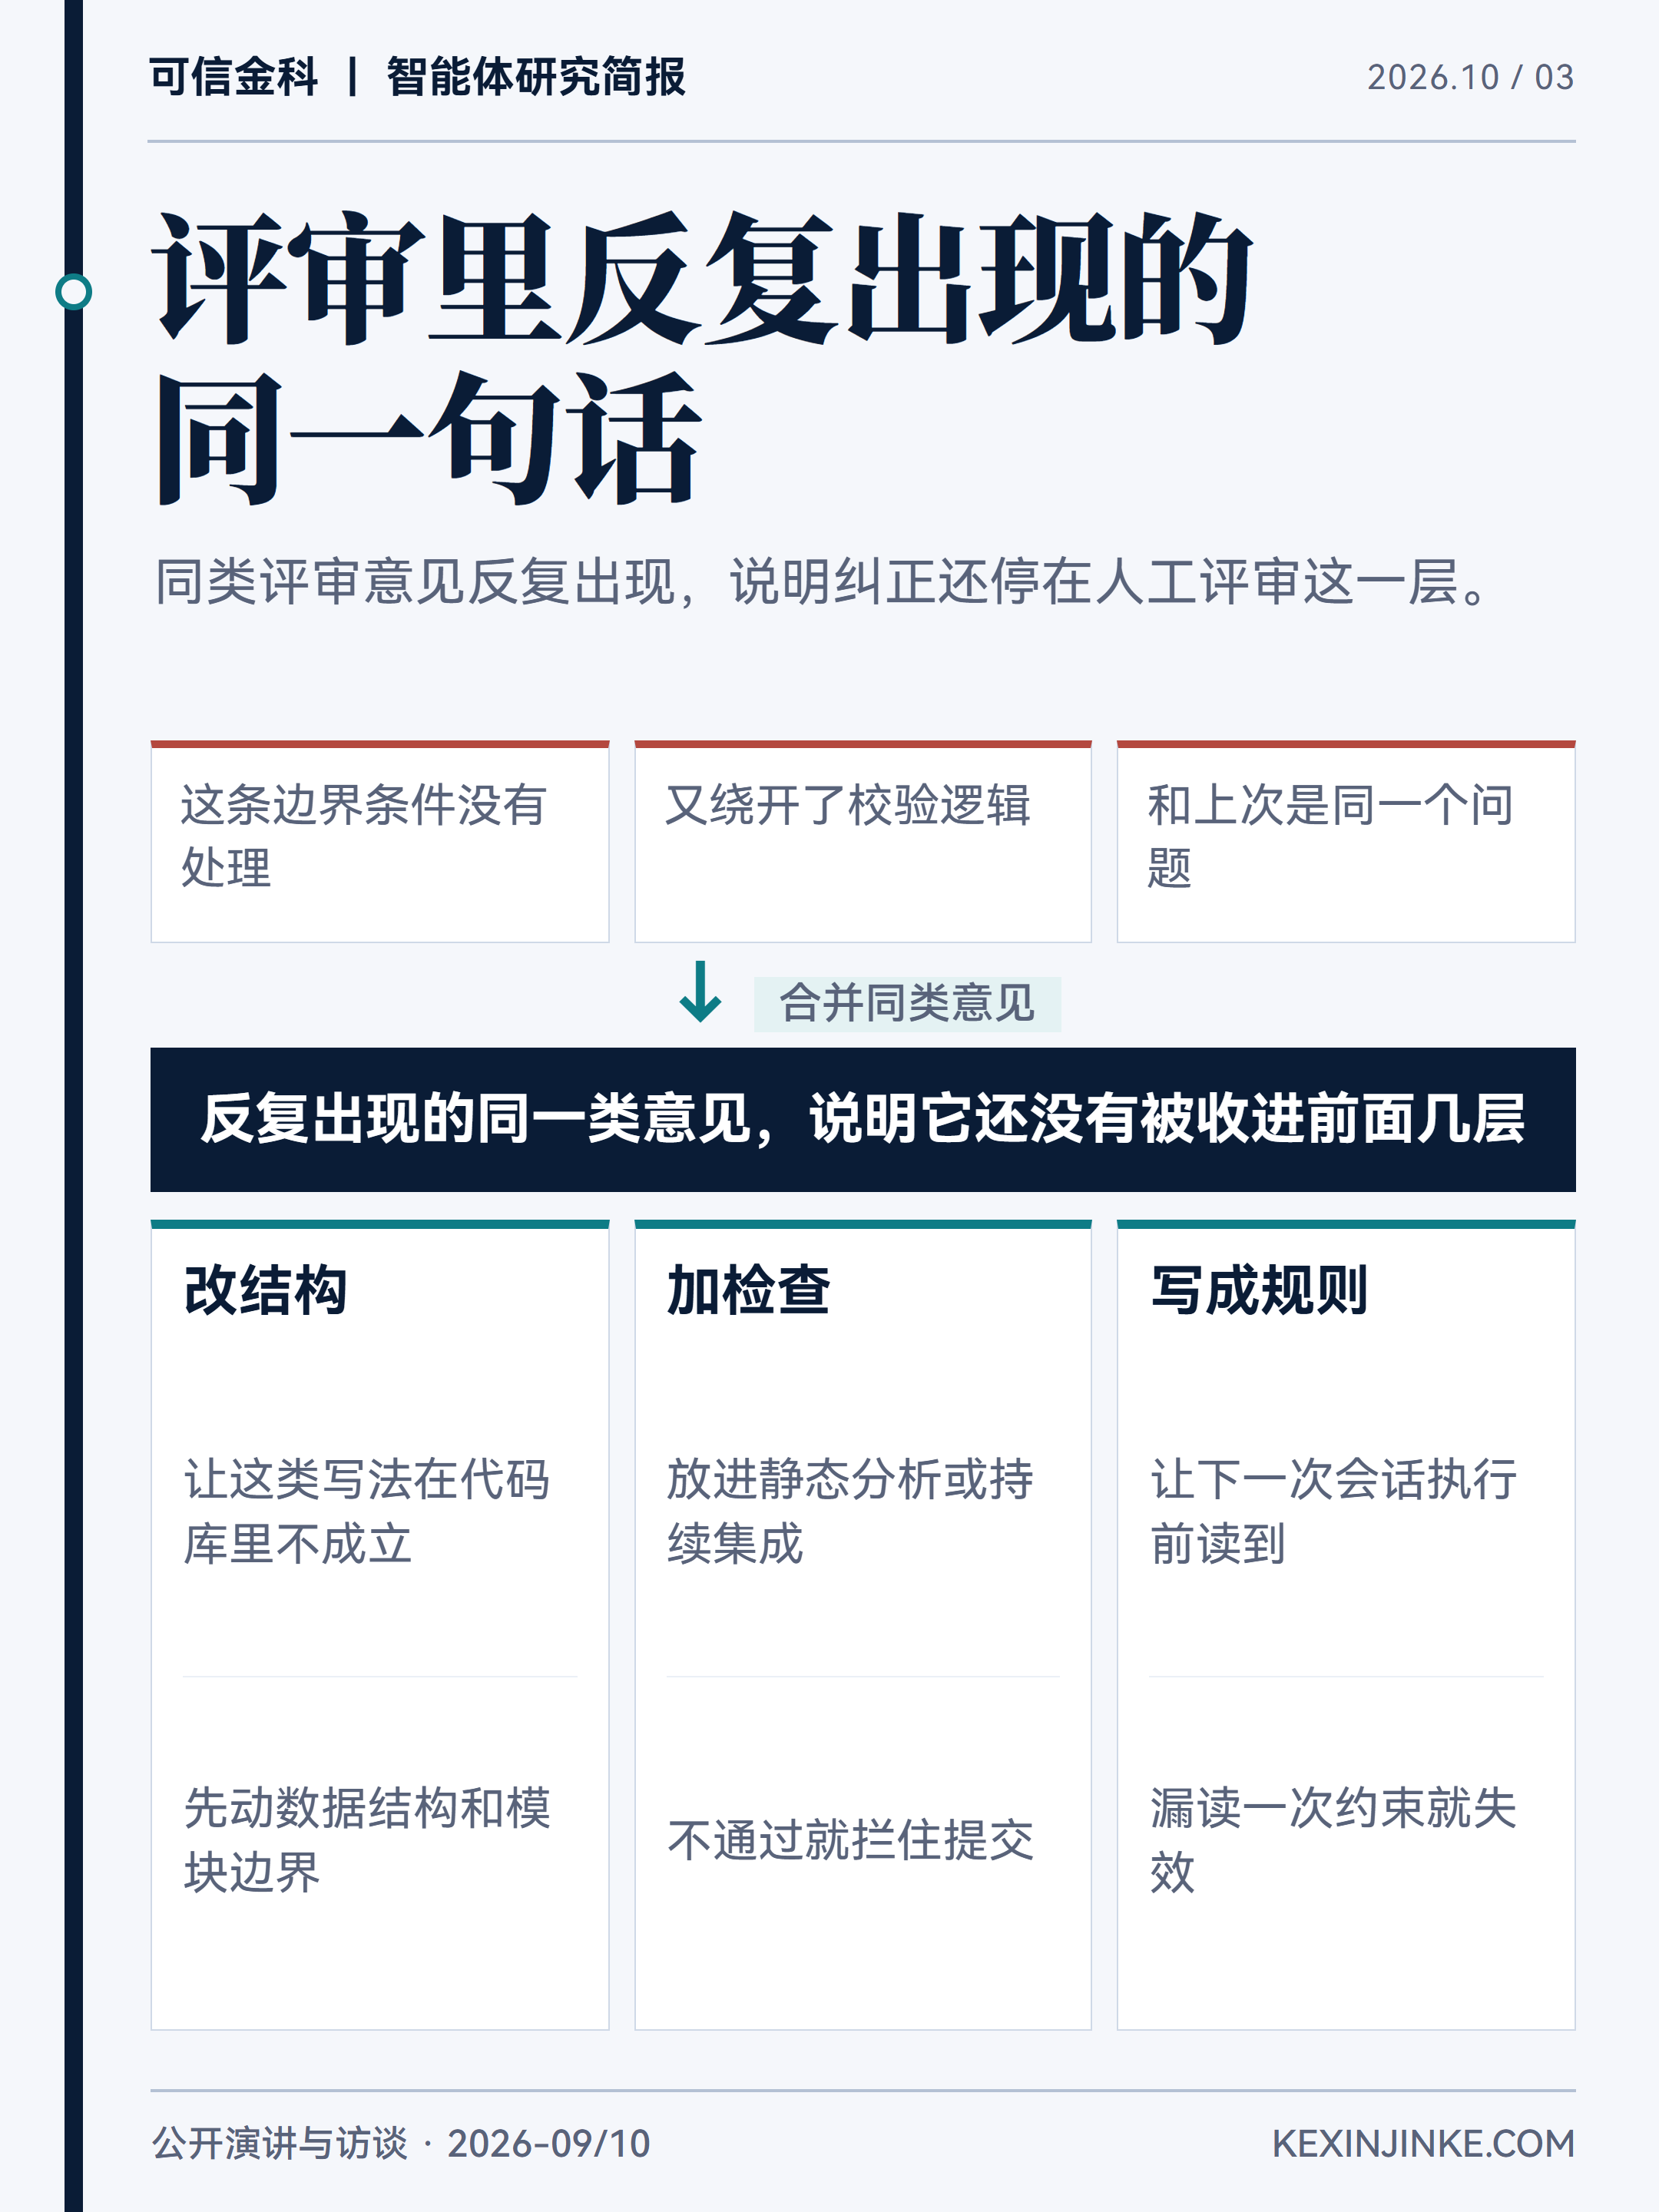
第二个常见动作是把人工评审当扩容手段。评审适合用来发现缺了什么,不适合承接产量。这里有一个好用的判断信号——同一类评审意见反复出现,说明它还停在第四层,没有被收进架构、静态分析或规则。
这也解释了"纠正过"和"不再犯"为什么是两件事。人纠正过,痕迹留在会话里;不再犯,要求这条痕迹在下一次执行之前就生效。
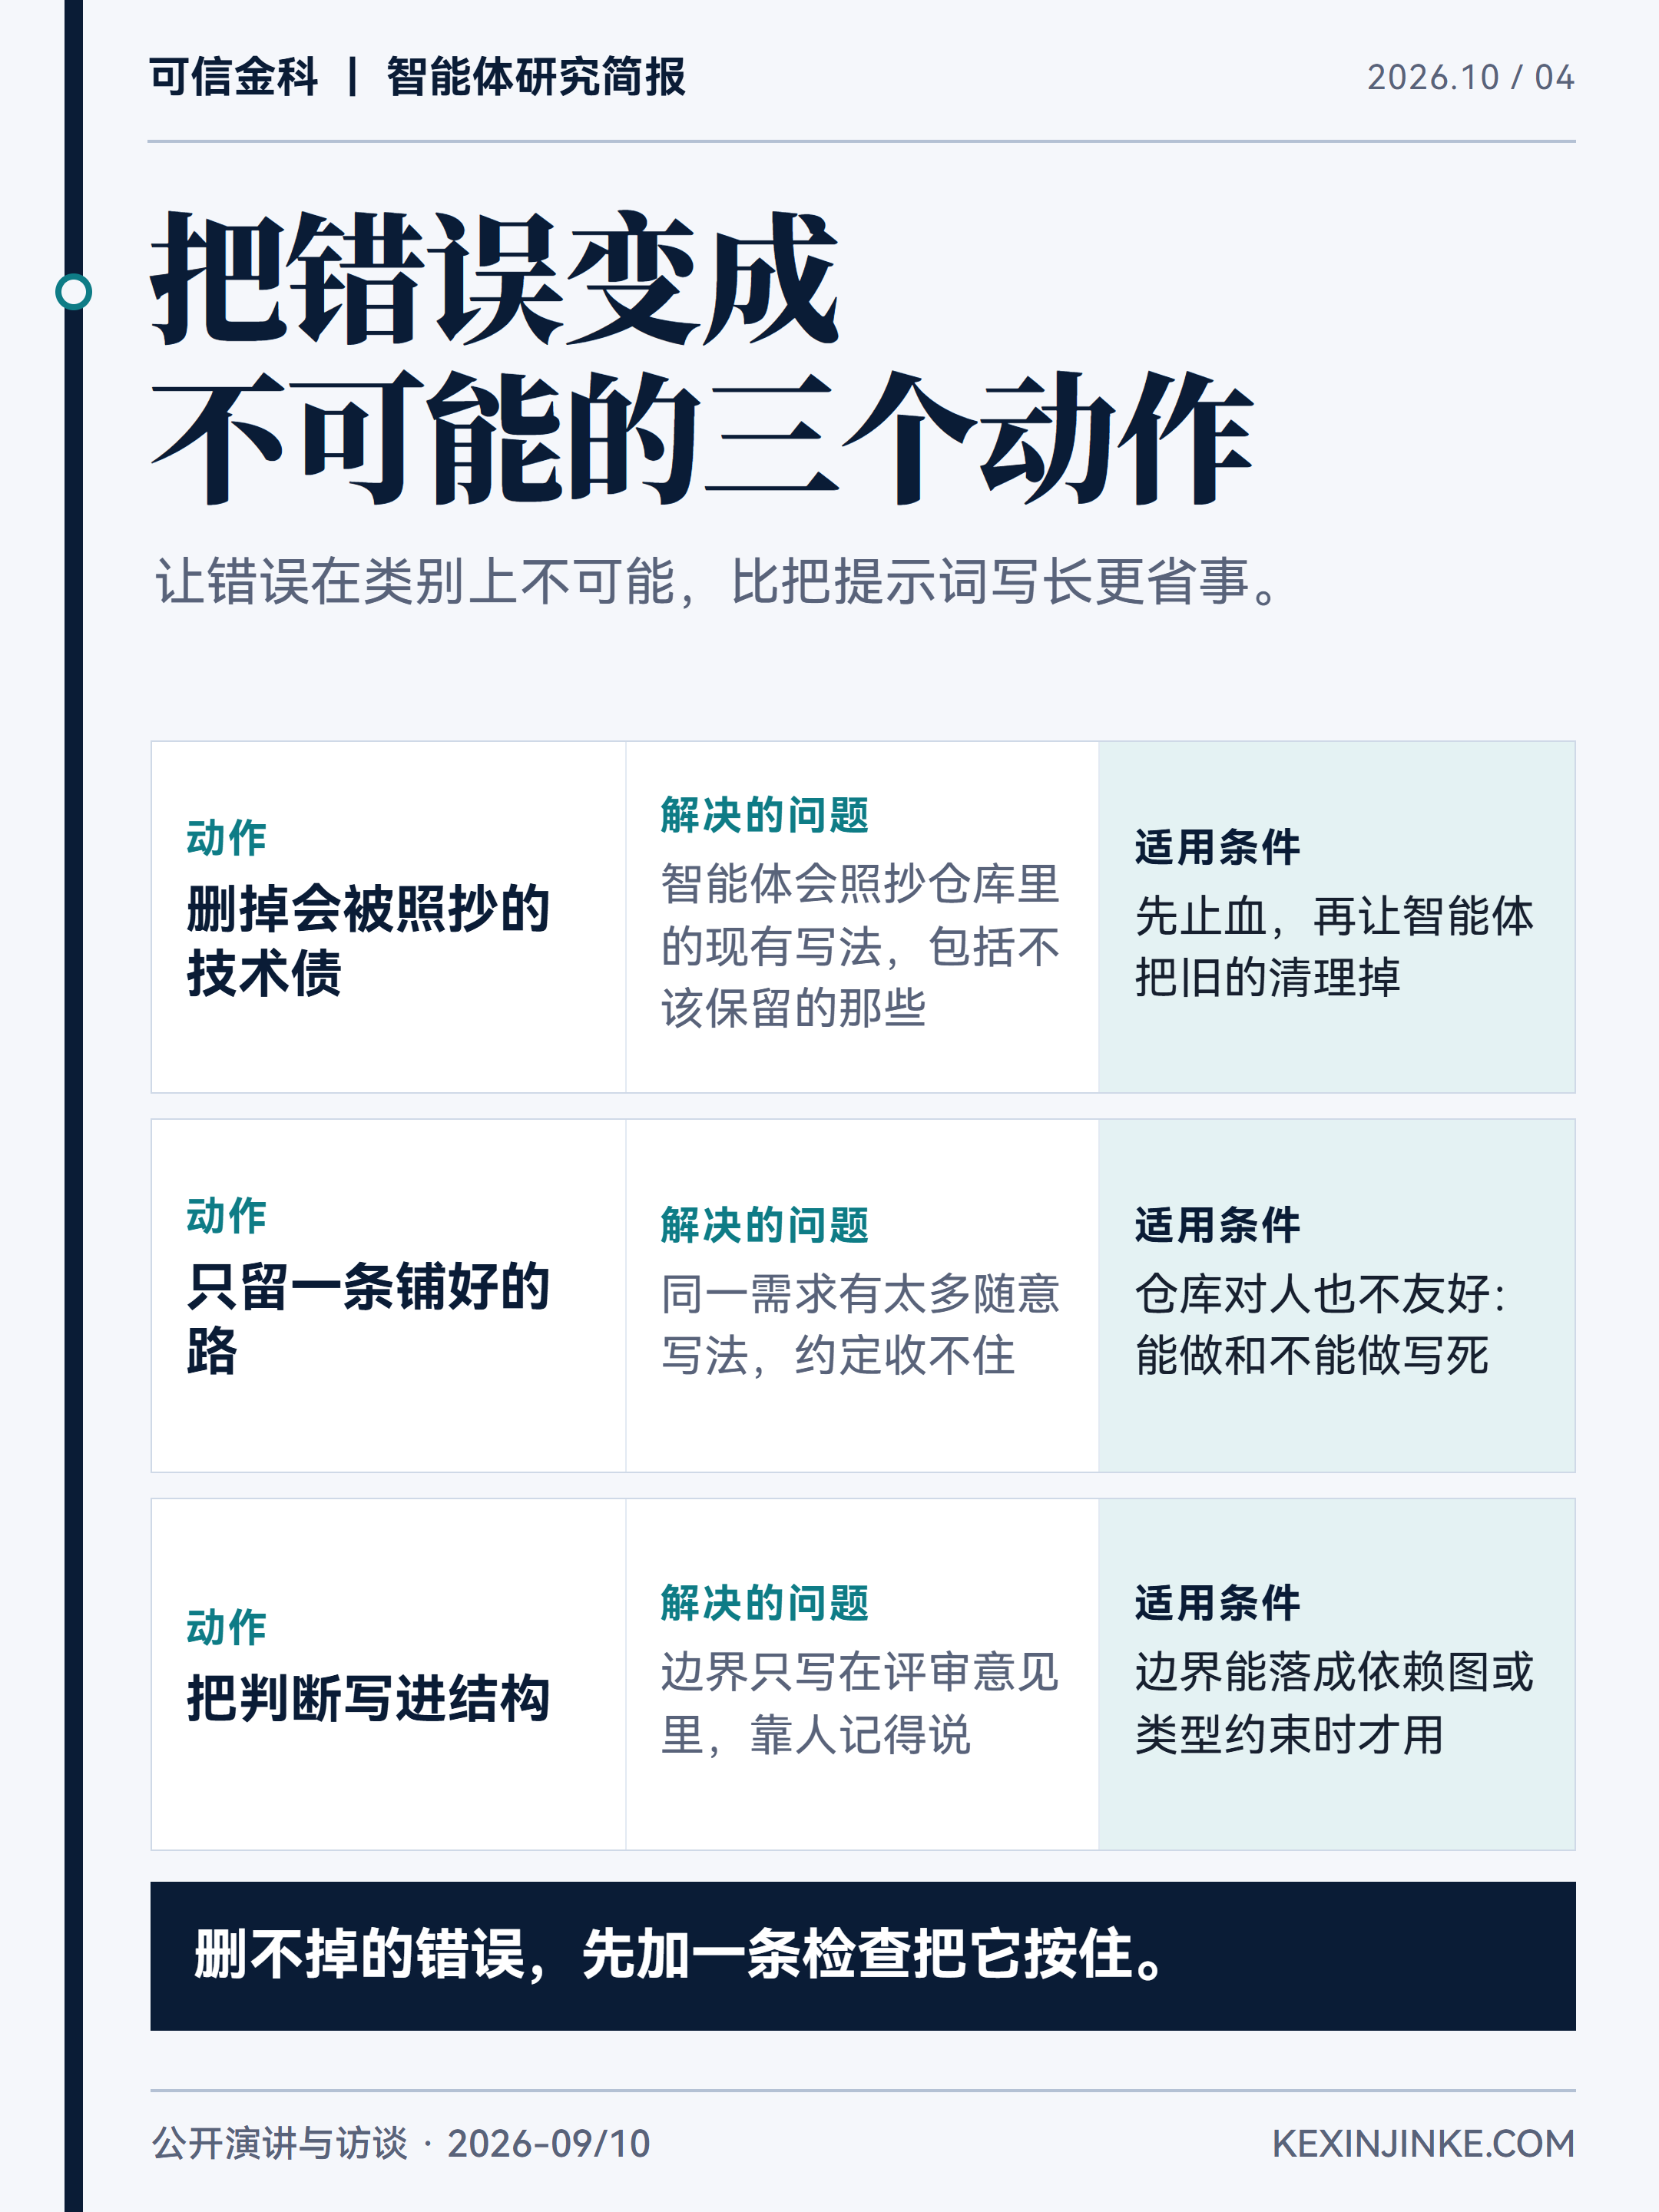
让错误在类别上不可能,比把提示词写长更省事
把纠正往前推的动作分两种。一种是清理仓库里已经有的东西:智能体会照抄现有写法,包括不该保留的那些,所以团队的做法是先止血,再让智能体把旧的清理掉,让仓库保持在"被抄也没关系"的状态。
另一种是让仓库本身少给智能体选择的余地。团队自建了一套客户端框架,把约定、功能目录、自动发现和严格的 lint 规则写进去,缩小实现同一个需求时的随意选择空间。这套框架对人类开发者并不友好,能做和不能做都被约定收得很紧;她认为这恰恰适合上下文很少的智能体。
框架里有一条边界来自实际的性能问题:主进程上运行的东西不允许跑到渲染进程,因为渲染进程要维持界面流畅,不能扛超过帧预算的长任务(大约 16 毫秒对应每秒 60 帧,8 毫秒对应每秒 120 帧)。这条边界用导入依赖图定死,误导入在类别上就不可能发生。
注释是这套框架里最反直觉的一处取舍。她把注释禁掉了,起因是看到智能体用注释给自己找理由,绕开问题本身,用短期办法把 bug 糊过去。注释在别处可能是好的,被用来解释一个绕过办法时,它同时成了下一个智能体的错误范本。
验证手段能证明的,和证明不了的
五层里最容易被高估的是验证手段。它由两块组成:一块是可复现的命令行工具,放在技能目录里,不让智能体每次任务现写一套脚本,因为临时脚本会在会话之间漂移,同一条性能线会量出不一样的结果;另一块是写进仓库的功能地图,记录应用怎么工作、有哪些功能、用户怎么到达、要操作哪些界面元素。只有工具不够用,拿到一张模糊的截图,智能体只能猜用户指的是哪里。
它拿出的证据只覆盖一件事:这件事做成了没有。代码快不快,写得好不好,它都答不了,性能要另采指标和遥测,代码质量要靠另一类技能。
成本也要算。多轮、多智能体的验证很消耗算力额度,她举例说可以把 10 个验证智能体调成 1 个。
不可逆的操作是另一个问题。通过某组测试,不能让一次已经发生的数据删除变得可逆。她的回答保留了不确定性:能明确验证结果的领域更容易建立这种工作方式,难以程序化验证的工作很难达到同样的自主程度。落到企业里,判断要看三件事:当前任务能拿出哪些完成证据、哪些后果仍然无法检查、出错后有没有可靠的恢复方式。
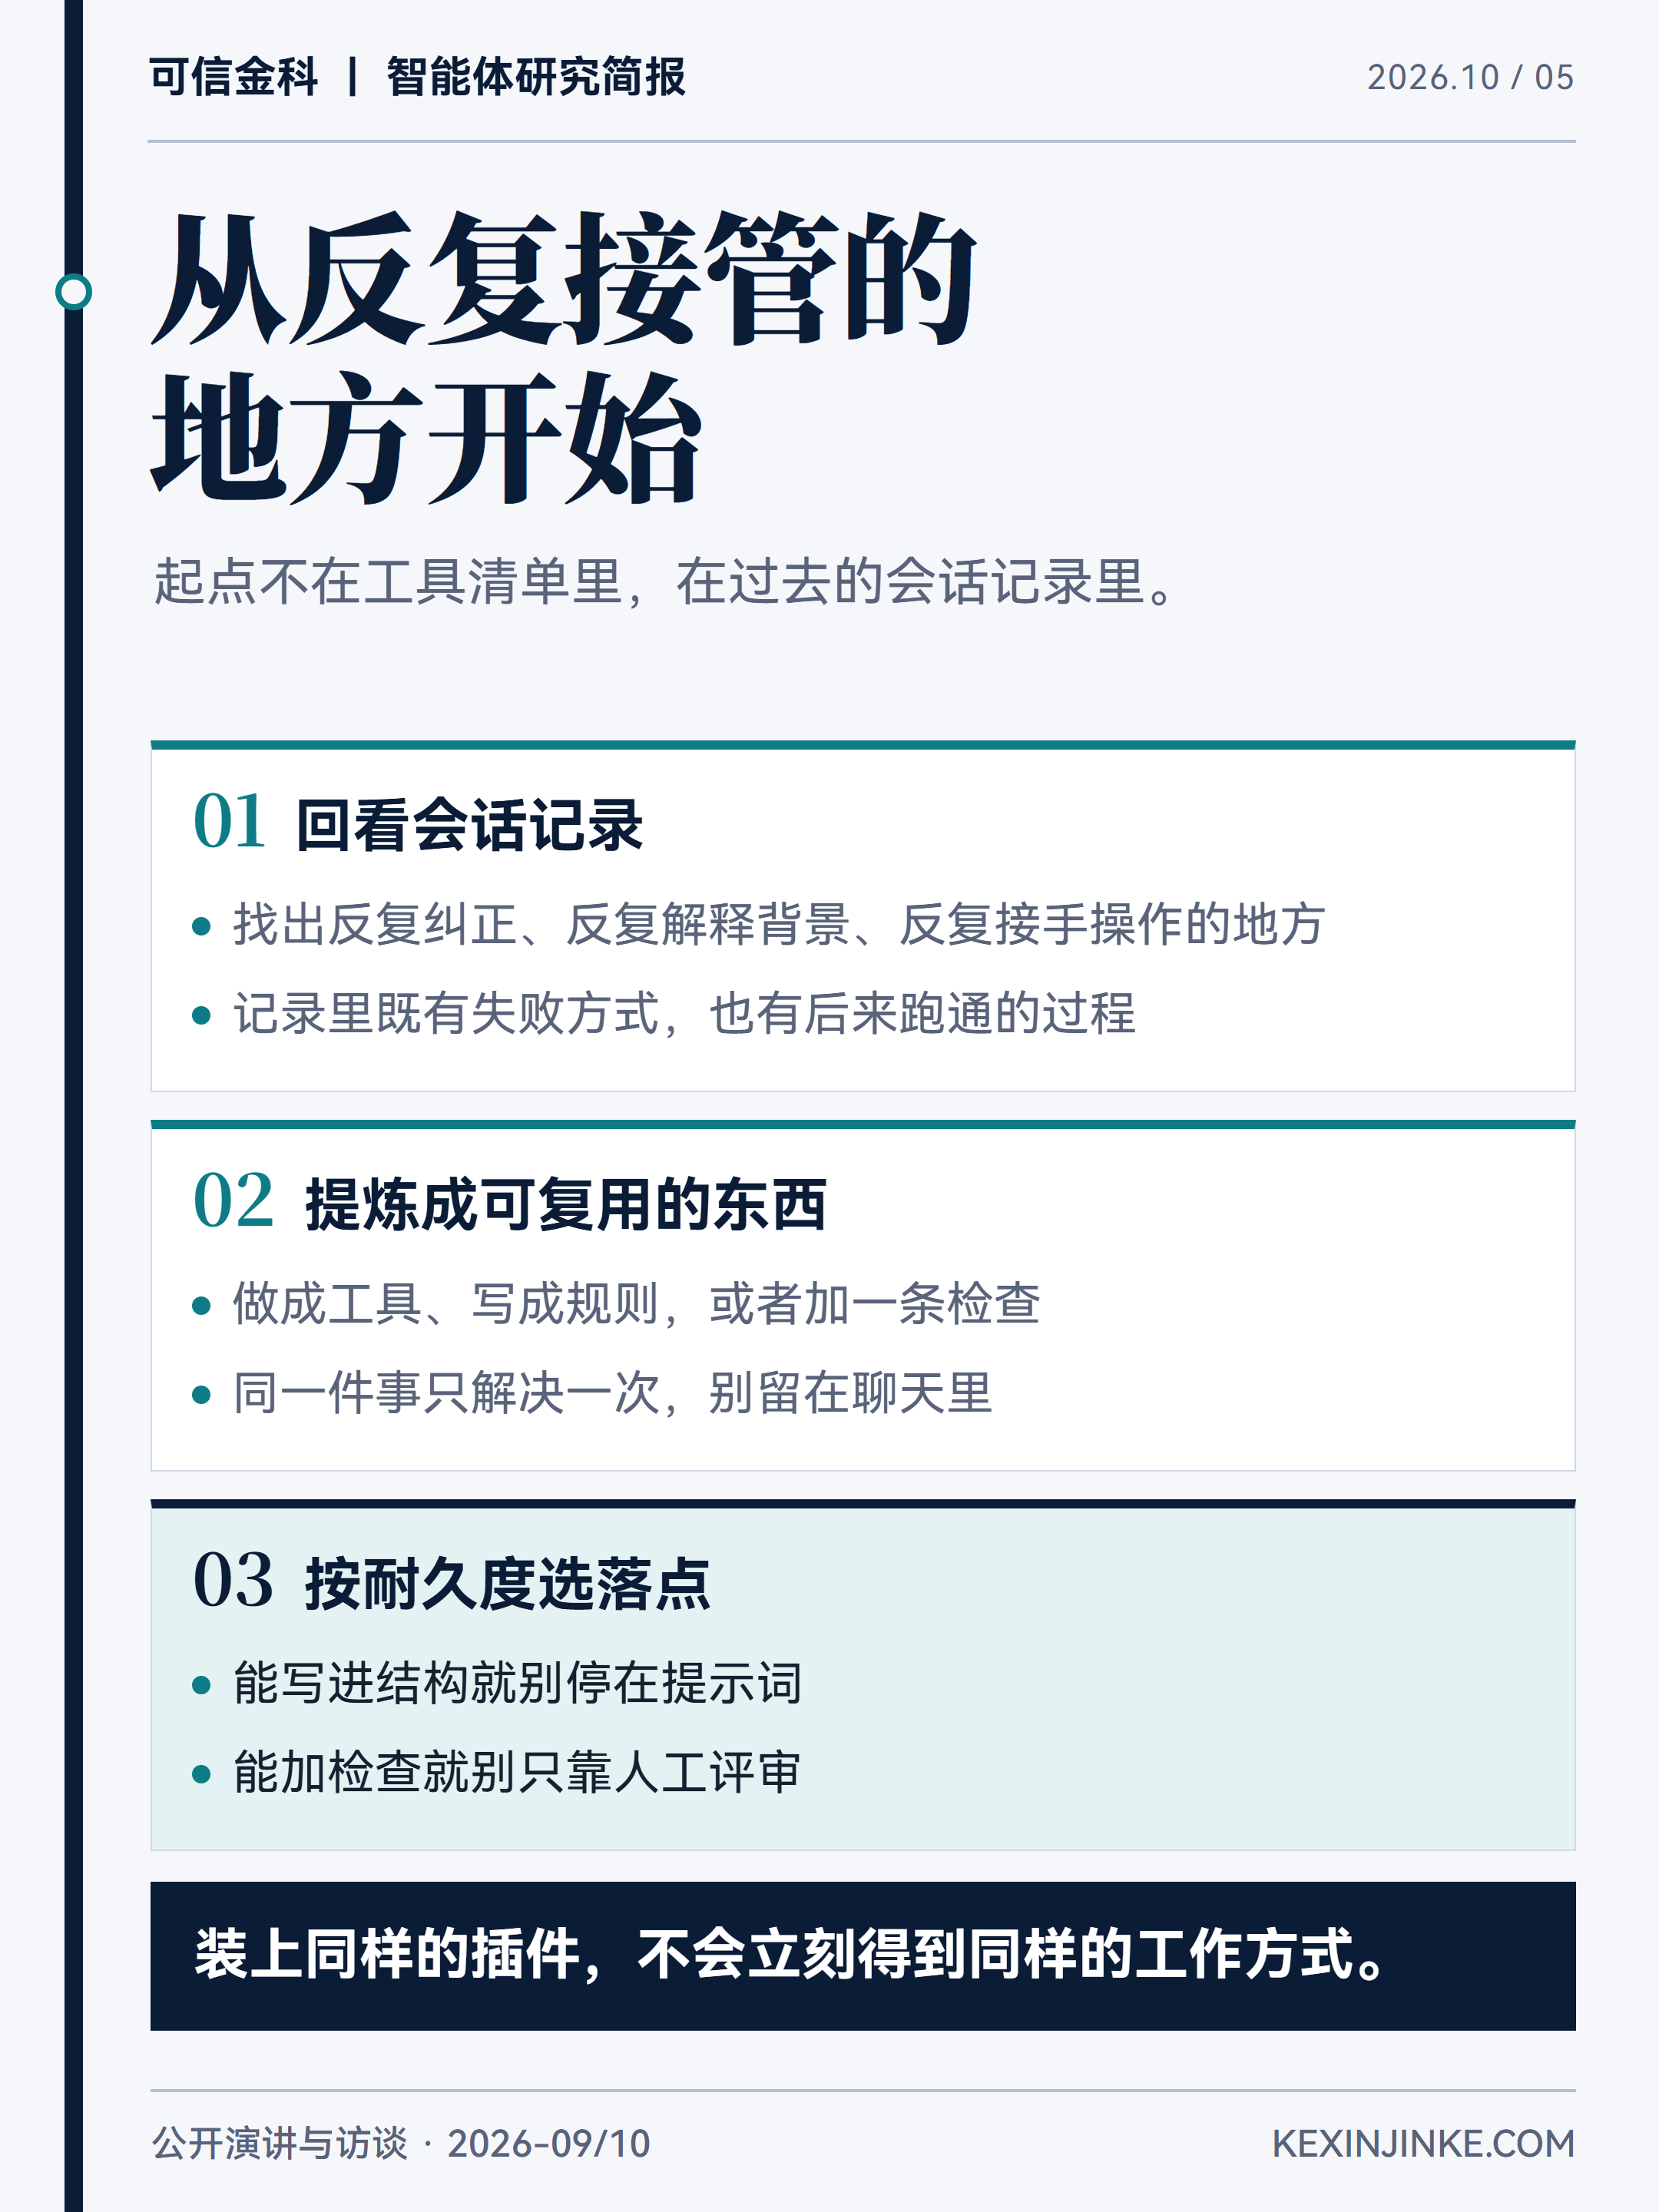
从反复接管的地方开始
起点不在工具清单里。回看过去一段时间的智能体会话记录,找出那些不得不反复纠正、反复解释背景、反复接手操作的地方,据此提炼成工具、规则或者一条检查,再决定它该落在五层里的哪一层。
装上同样的插件不会立刻得到同样的工作方式;她自己提醒过,达到这个阶段需要大量时间和有意识的调整。
同类错误反复出现,仅靠每次提醒,很难约束下一次执行。我们可以和你一起把业务规则、校验条件和失败样例落实到系统与评测中,欢迎联系我们 。
纠正落进仓库,才管得住下一次。
系列阅读:上一篇:研发资产盘点 · 第二篇:先补齐验证手段 。相关服务:垂类智能体开发服务 。