团队把全部表接给大模型,演示时问得出,换口径或换期间后回答开始漂移。业务语义缺位直接导致答案漂移。
更隐蔽的漂移发生在表与表之间。同一个“收入”,在财务表里按会计确认口径,在销售表里按签约金额,在项目管理表里按回款计划或项目进度。三张表都叫“收入”,直接接给大模型,它会把三个数拼在一起,生成一个貌似准确、实则口径不一致的答案。老板看到的是一个确定的数字,却不知道这个数字背后混了三种含义。
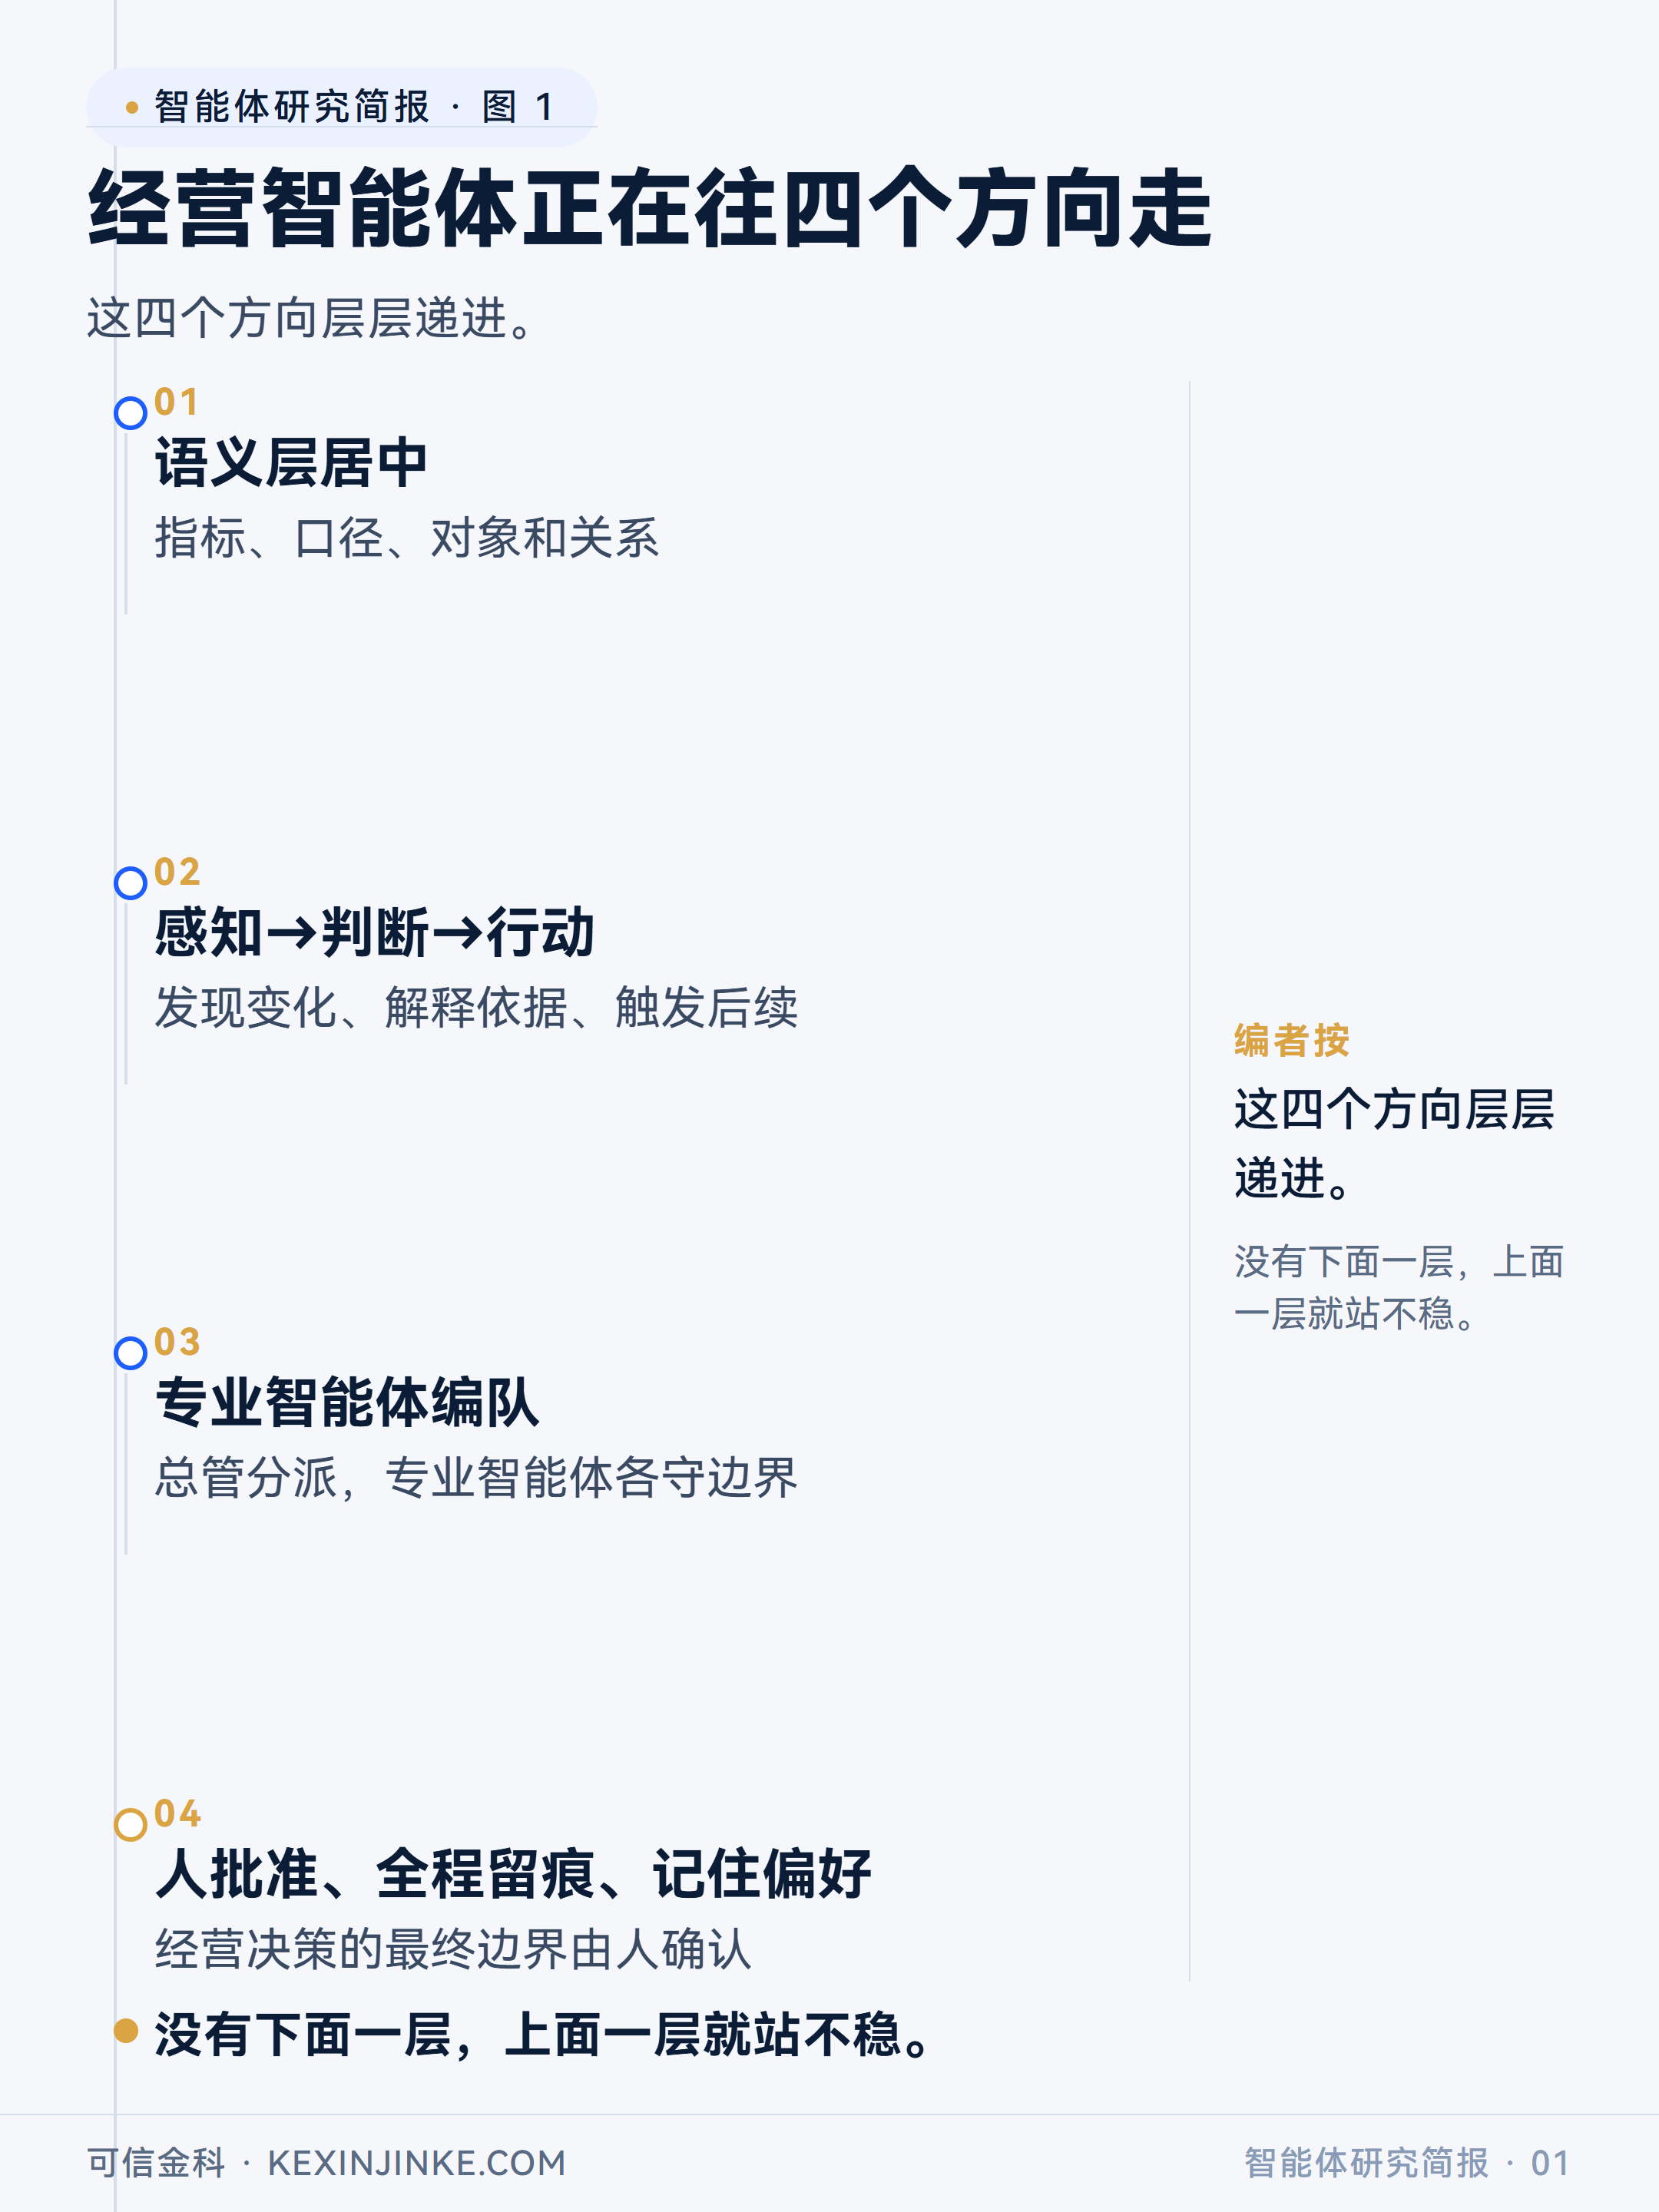
2026 年,企业 AI 产品不再把“接一个大模型直接问数据库”当作经营智能体。多家厂商的公开动作显示,经营智能体正在收敛到四个方向。四个方向按依赖关系逐层搭建。
语义层放在中间
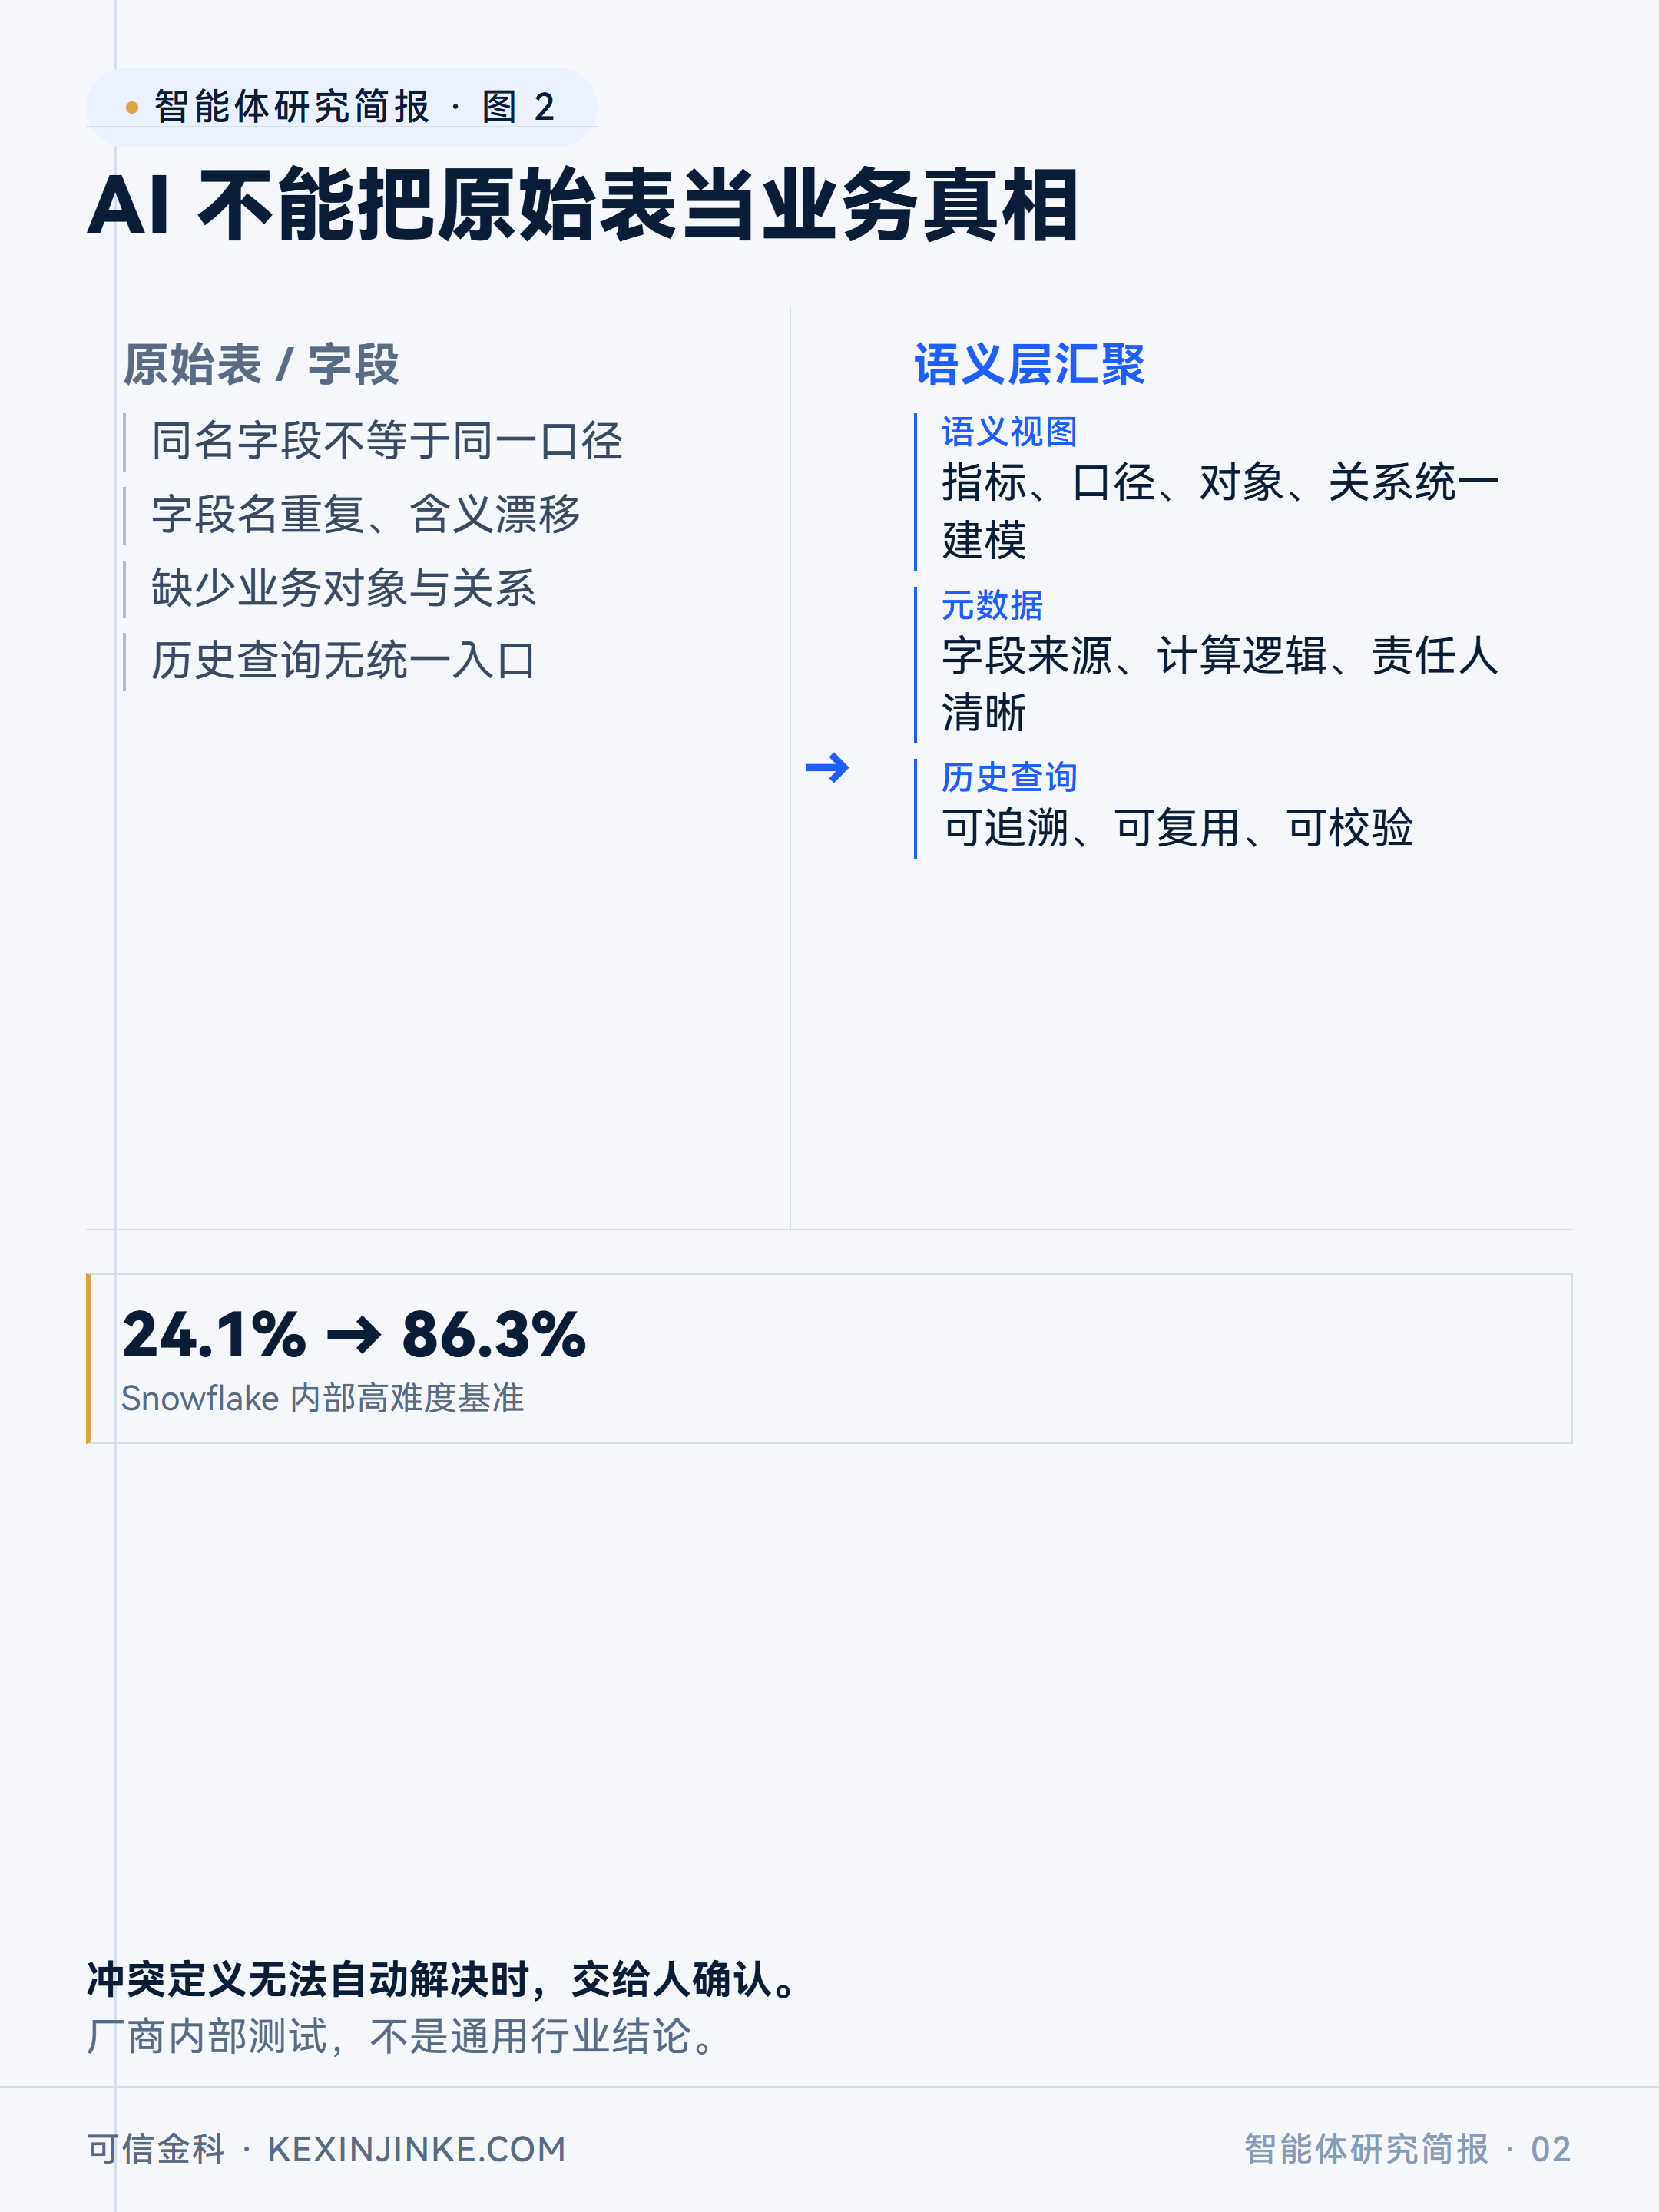
Snowflake 2026 年介绍 Cortex Sense 时写得很直接:系统使用语义视图、元数据、历史查询等信号建立业务上下文。在 Snowflake 自己的一组高难度内部基准中,加入 Cortex Sense 后,准确率从 24.1% 提高到 86.3%。这是厂商内部测试,不是通用行业结论,但它指向一个关键判断:AI 不能把原始表当业务真相。
原始表里没有“收入”的口径,没有“活跃客户”的定义,也没有“回款周期”的计算规则。大模型直接查表,只能猜。猜一次可能对,换期间、换口径就漂。更麻烦的是,当财务、销售和项目管理三张表同时出现“收入”字段时,仅凭字段名,模型无法可靠判断本次该采用哪个口径,也未必主动说明选择依据。
Microsoft Fabric 2026 年的文章同样把语义模型和 ontology 放在智能体能力之前:语义模型提供受治理的业务指标,ontology 定义业务实体和关系。Databricks 2026 年 AI/BI 与 Genie 更新持续强化 metric view、受治理数据源和 agent 使用监控,也说明语义指标和治理正在产品化。Palantir 的公开文章同样强调以 ontology 提供业务对象与关系,把智能体连接到业务决策。
方向很清楚:语义层是中间层。AI 面对的不是表,而是指标、口径、对象和关系。
但语义层不能是一次性建好就固定不变的。经营中会不断冒出新的追问,追问会暴露新的指标和新的口径。合理的做法是:AI 批量归纳候选指标或候选口径,由人确认后才能生效。每一次确认都要写清旧版本、新版本和确认人,留痕可查。这样语义层越用越厚,但口径不会悄悄变化。没有这层确认机制,语义层本身也会变成另一种漂移来源。
从“等人来问”走向“感知→判断→行动”
有了语义层,智能体才可能主动发现变化。Microsoft Fabric 的文章写到:智能体可以发现关键指标变化、生成更新、触发跟进并安排下一步。Oracle 2026 年 3 月发布的 Fusion Agentic Applications 也把常规动作放在边界内推进,例外、权衡和需要人工判断的决定交给人。
这里要分清:主动发现变化,不等于替老板做决定。智能体可以感知指标异动,解释依据,触发后续动作。但“行动”的终点是提醒、生成更新、安排跟进,不是擅自拍板。
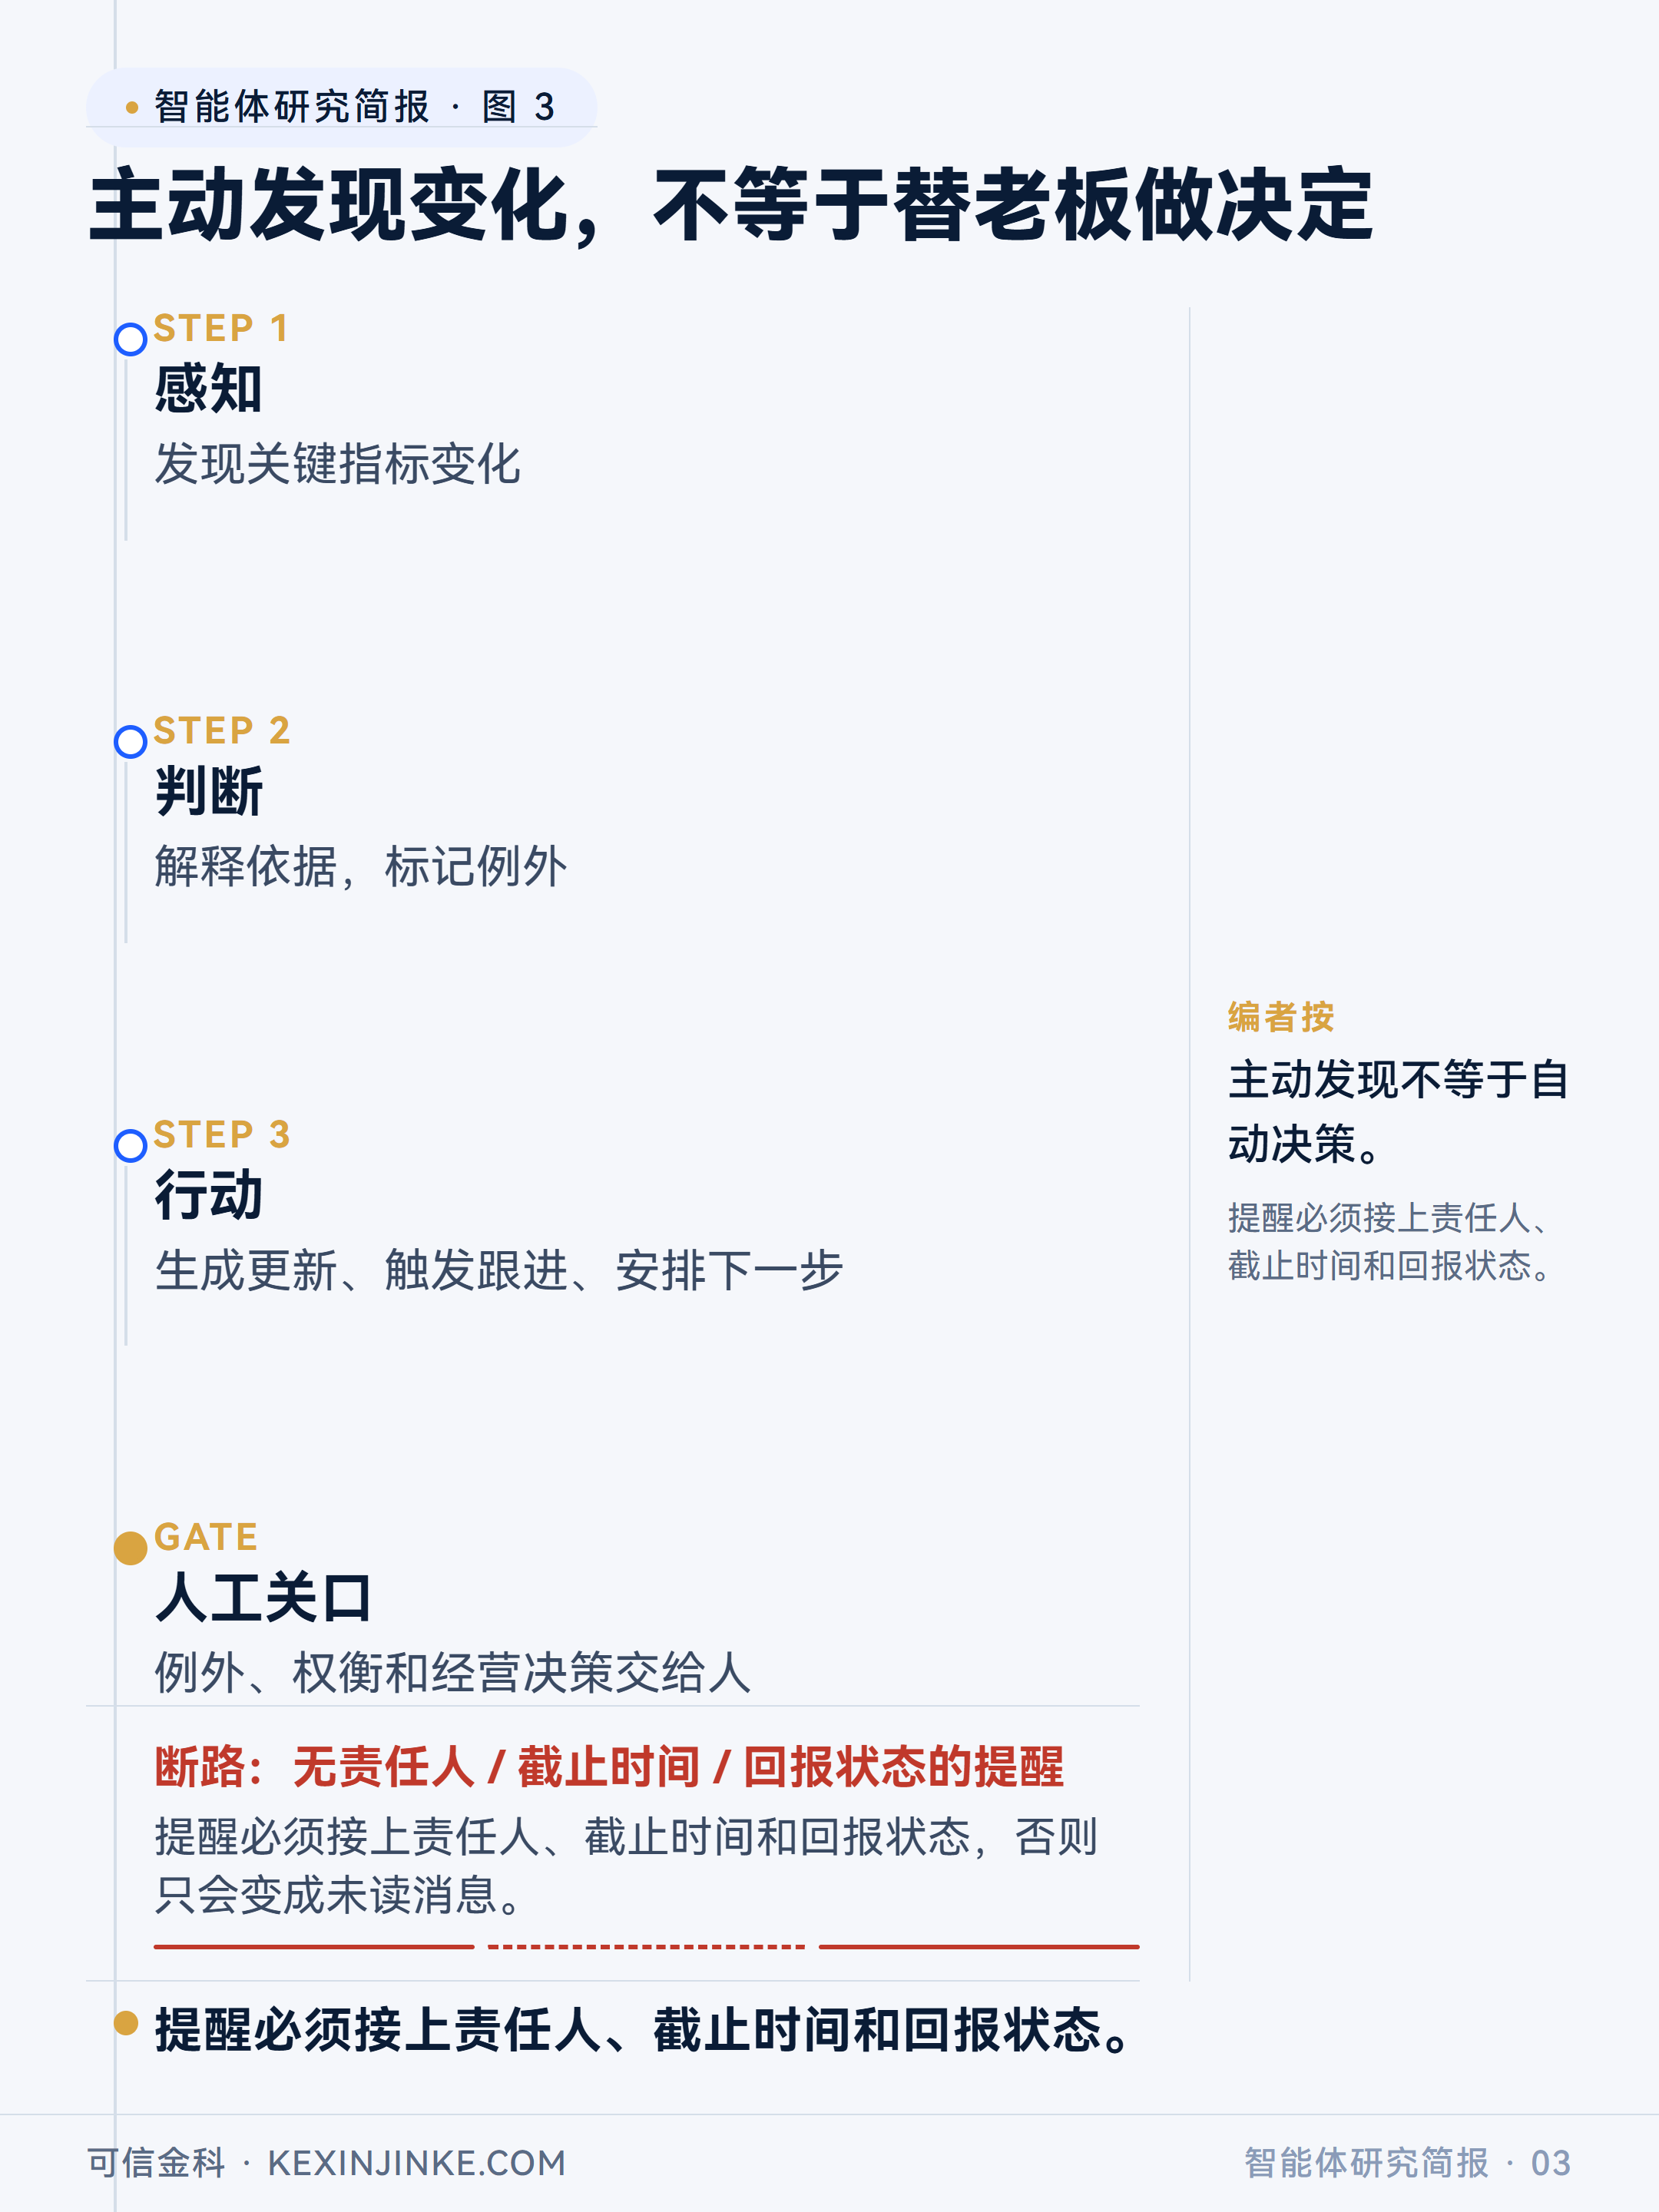
主动感知还会带来一个具体摩擦:系统发现收入异动后,推送提醒之后,还必须接上责任人、截止时间和回报状态,这条提醒很快会变成另一条未读消息。老板看到提醒时可能已经过了三天,点开之后不知道谁在管、管到哪一步、卡在哪里。主动感知的价值在于发现之后能不能进入一个有人负责的闭环。
SAP 2026 年 5 月被 CFO Dive 援引的发布信息显示,其整体方案包含 50 多个领域助手,协调 200 多个专业智能体;财务方向覆盖关账、计划、开票、治理、税务合规、应收和资金管理,并强调可解释判断、实时处理和可审计性。可审计性这个词值得注意:主动感知越强,留痕要求越高。
专业智能体编队,各自承担有边界的任务
Oracle 的 Fusion Agentic Applications 明确由有具体角色、专业能力和决策权限的智能体团队协同,当时公布 22 个新的智能体应用。SAP 的 50 多个领域助手协调 200 多个专业智能体,也是编队逻辑。
这不是厂商在堆数量。经营问题天然分散:收入异动、应收逾期、口径冲突、预算偏差,各自需要不同的数据范围和判断规则。一个大模型包打天下,要么回答太泛,要么权限太宽。
编队的意义在于边界。总管负责分派和汇总,专业智能体各自承担有边界的任务。边界内可以自动推进,边界外交给人。
人批准、全程留痕、记住偏好
Snowflake 的文章还写了一句容易被忽略的话:冲突定义无法自动解决时会交给人确认。Oracle 的表述也把需要人工判断的决定交给人。金蝶 2026 年 5 月发布的企业 AI 操作系统“灵基” 同样强调 AI 自主执行任务、人在关键决策时做判断。
这些表述共同指向一个产品原则:高风险动作要人工确认,过程可审计。记忆只保存经确认的偏好和口径,不能把模型猜测写进长期记忆。否则智能体会越用越固执,把一次错误当成长期规则。
一个守住权限边界的经营管家
基于这四个方向,可以推导一个适度超前的产品形态:一个经营管家,加五个专业智能体。部分能力已上线,其余为规划中的目标形态。
经营管家面对老板,理解问题,分派给合适的专业智能体,汇总成一个回答。它记住老板长期关心的主题和已经确认的口径。五个专业智能体各有分工:
“盯”感知指标变化和待关注事项。“问”回答临时经营问题。“算”完成分析与多口径并列测算,不偷偷取平均。“治”发现口径、字段、来源和权限问题,发起确认。“跟”在老板拍板并指派后,盯进度、到期提醒、回来汇报。
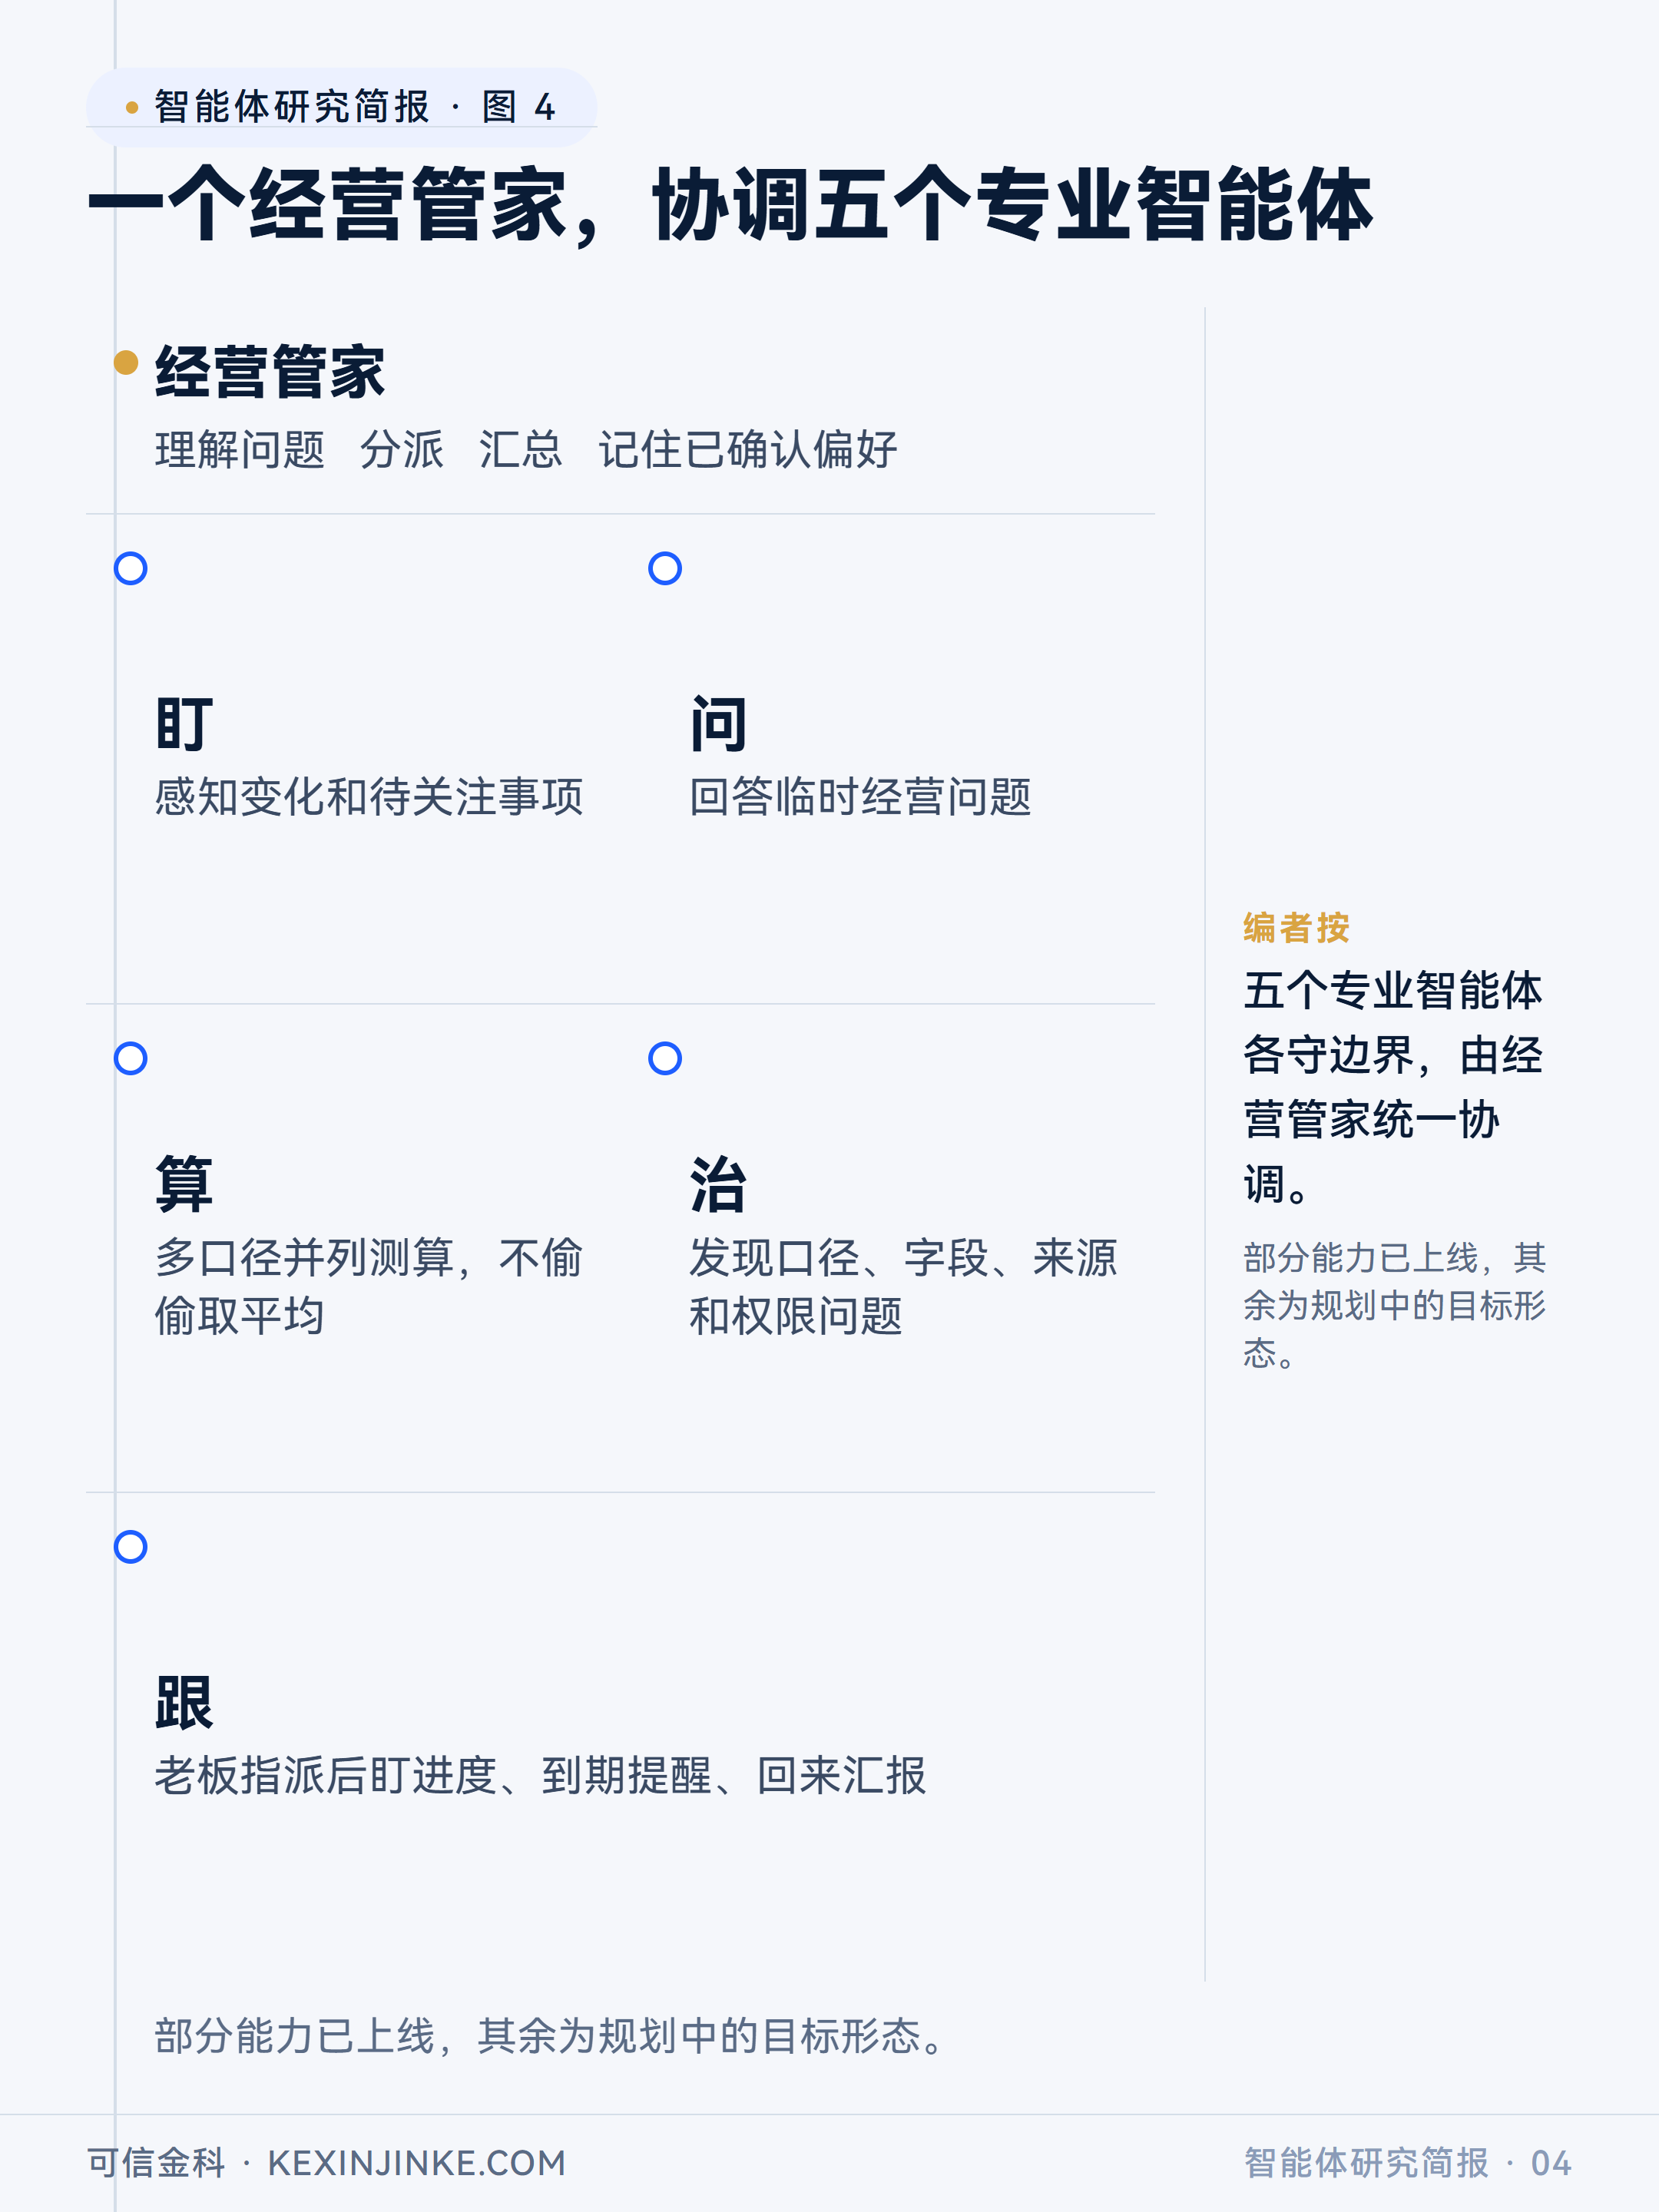
“跟”的运行条件必须写清楚:它只在老板拍板并指派以后运行。拍板之前,“跟”不启动。启动之后,它记录责任人、截止时间、当前状态、阻塞原因,并在关键节点回来汇报。它的硬边界是:只列问题,不替老板出方案;不代替审批,不自动付款,不替人作经营决策。
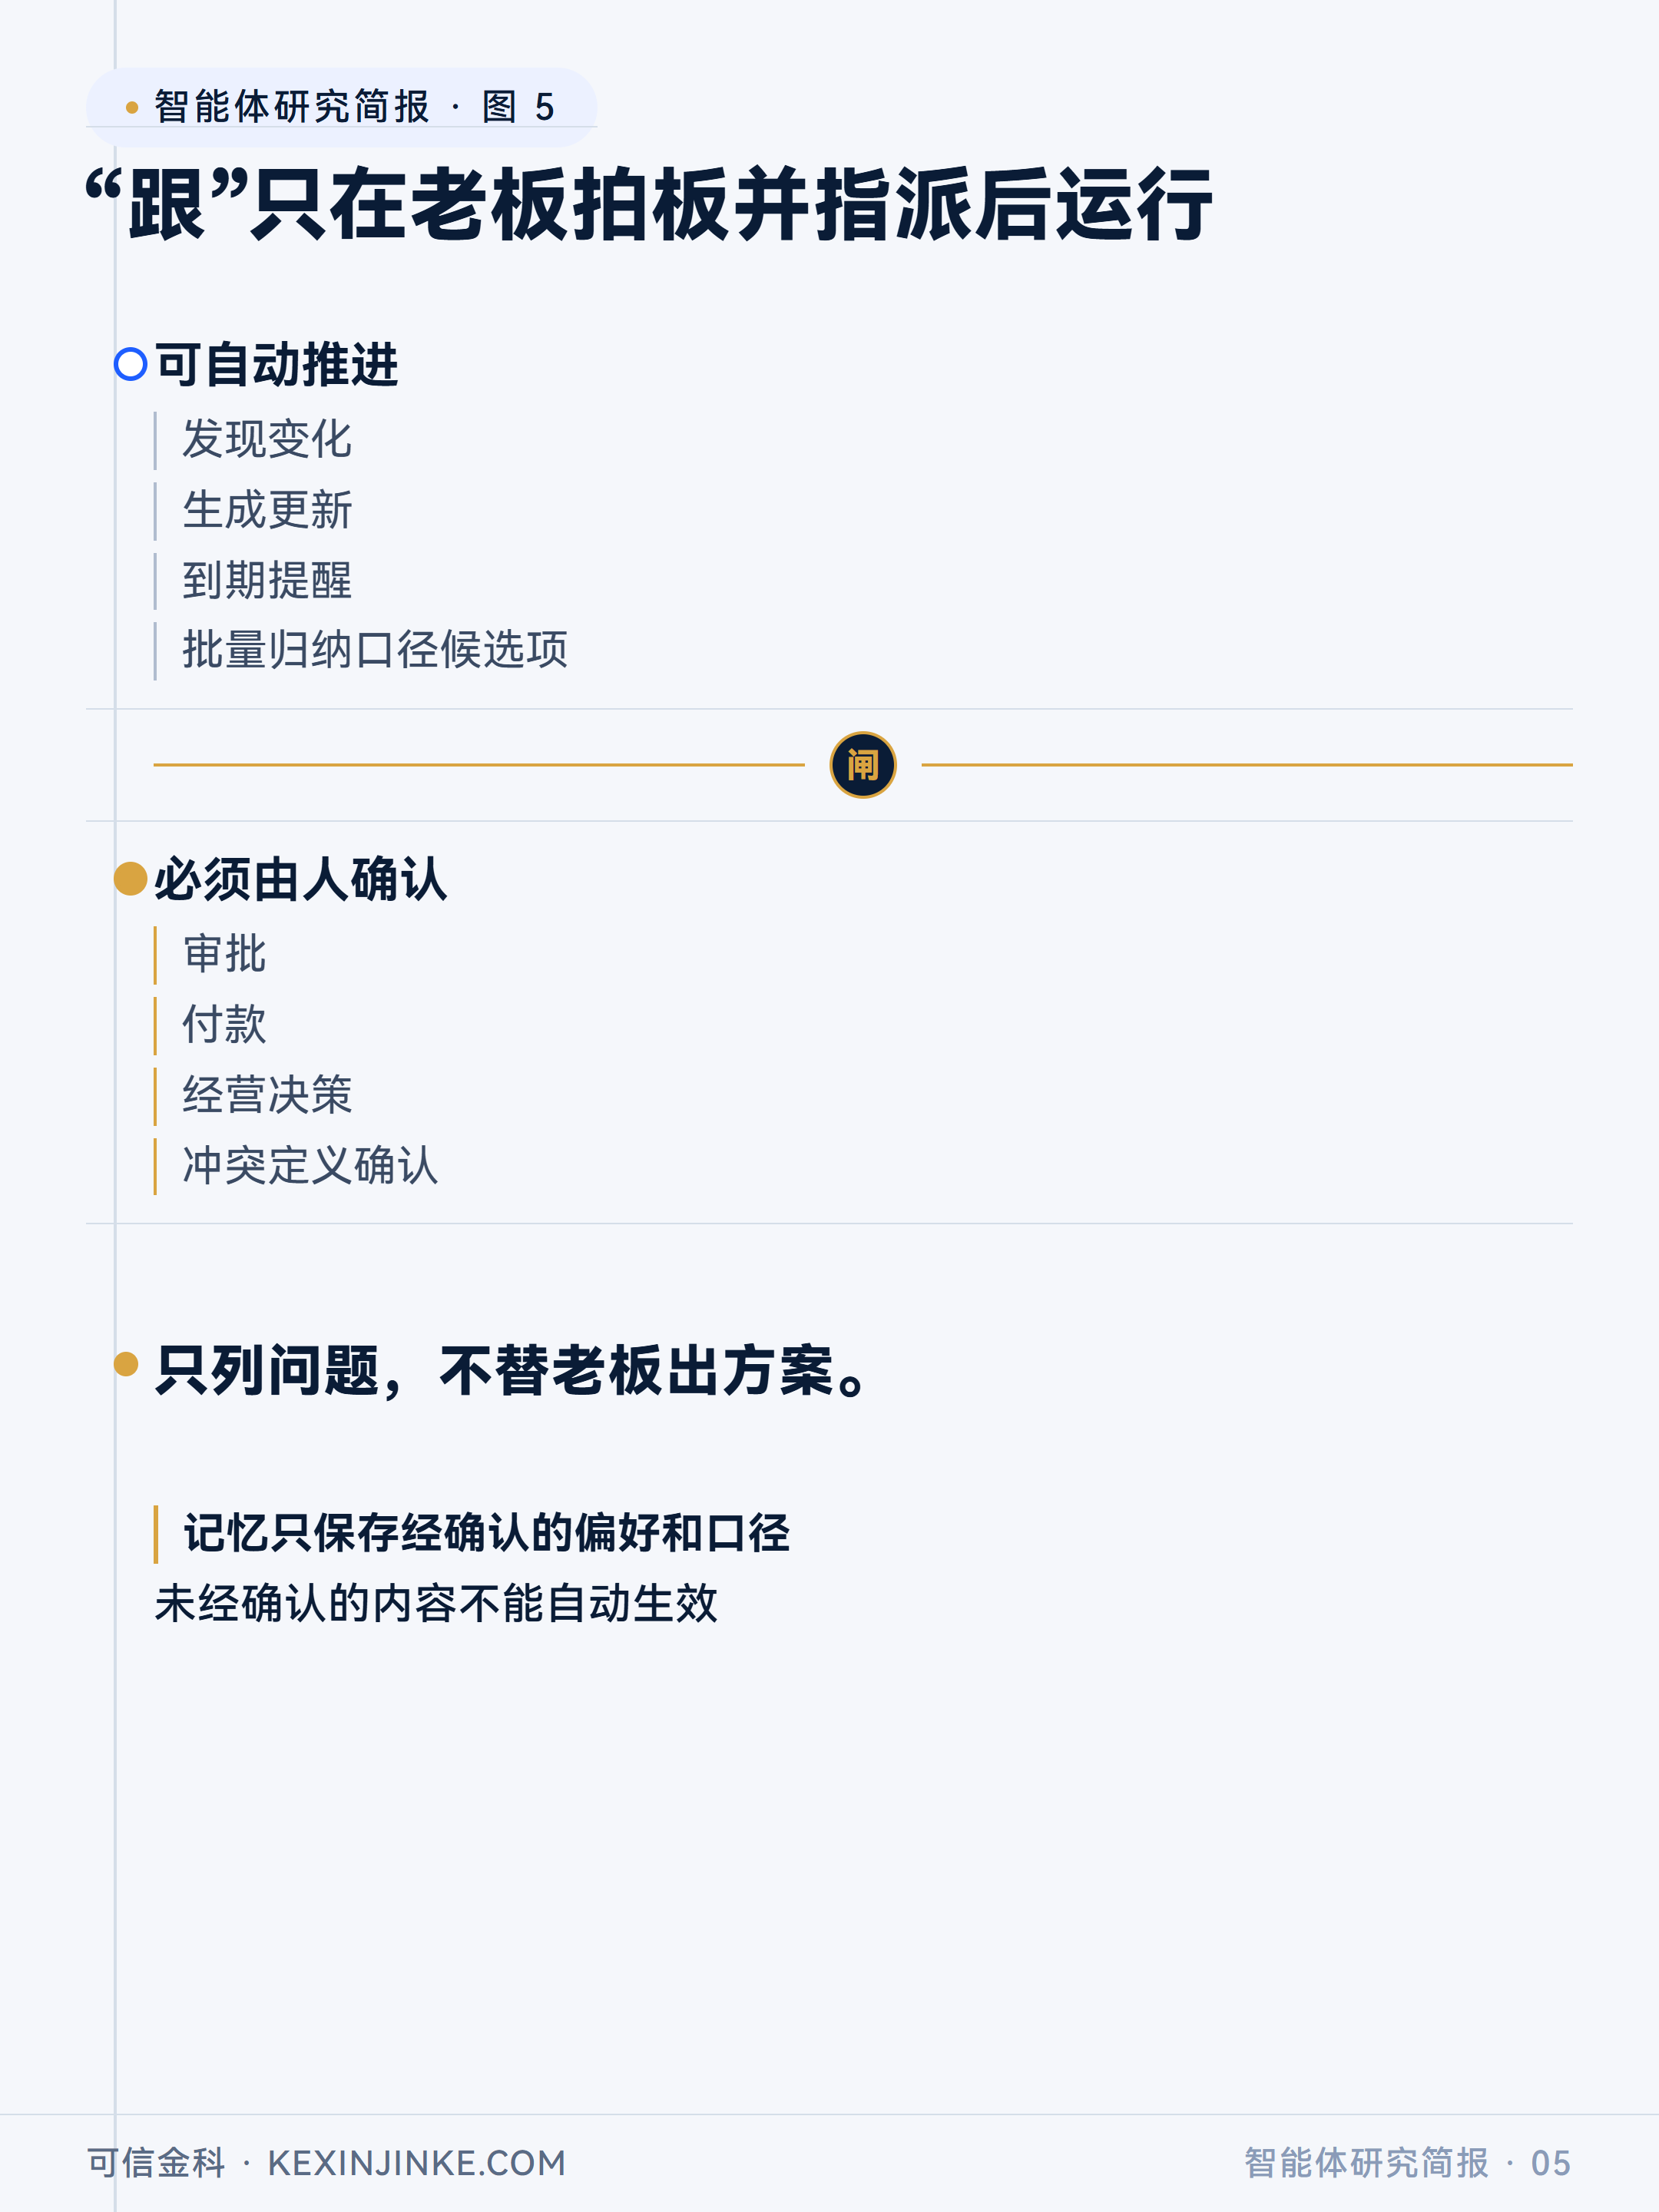
一层经营语义是这套形态的地基。新问题暴露新指标或新口径时,AI 可以批量归纳候选项,由人确认后进入语义层。旧版本和确认人必须留痕,避免口径悄悄变化。这一层越用越厚,但未经确认的内容不能自动生效。
选型时怎么判断?看三点:语义层是否可核对,多口径能否并列呈现,能否连接既有系统而不要求先替换某一套 ERP。金蝶公开优势是与自身 SaaS、财务体系原生结合;本文推导的另一条路径从老板问题出发,强调口径可核对、多口径并列和连接既有系统。前者强在原生业务底座,后者把重点放在经营问题的可解释和可确认上。
验证这套方向是否适合自己,可以拿最近一次经营会留下的真实追问做小范围测试:把追问丢给系统,观察它能否指出采用的口径和来源,能否在口径冲突时并列呈现并明确标出冲突,能否在老板拍板后把事项交给明确责任人跟进。三项验证跑通后,企业便能判断这套方向是否适合自己。
可信金科结合经营智能体项目的需求梳理与方案设计经验,提供场景评估、定制开发和系统对接支持。