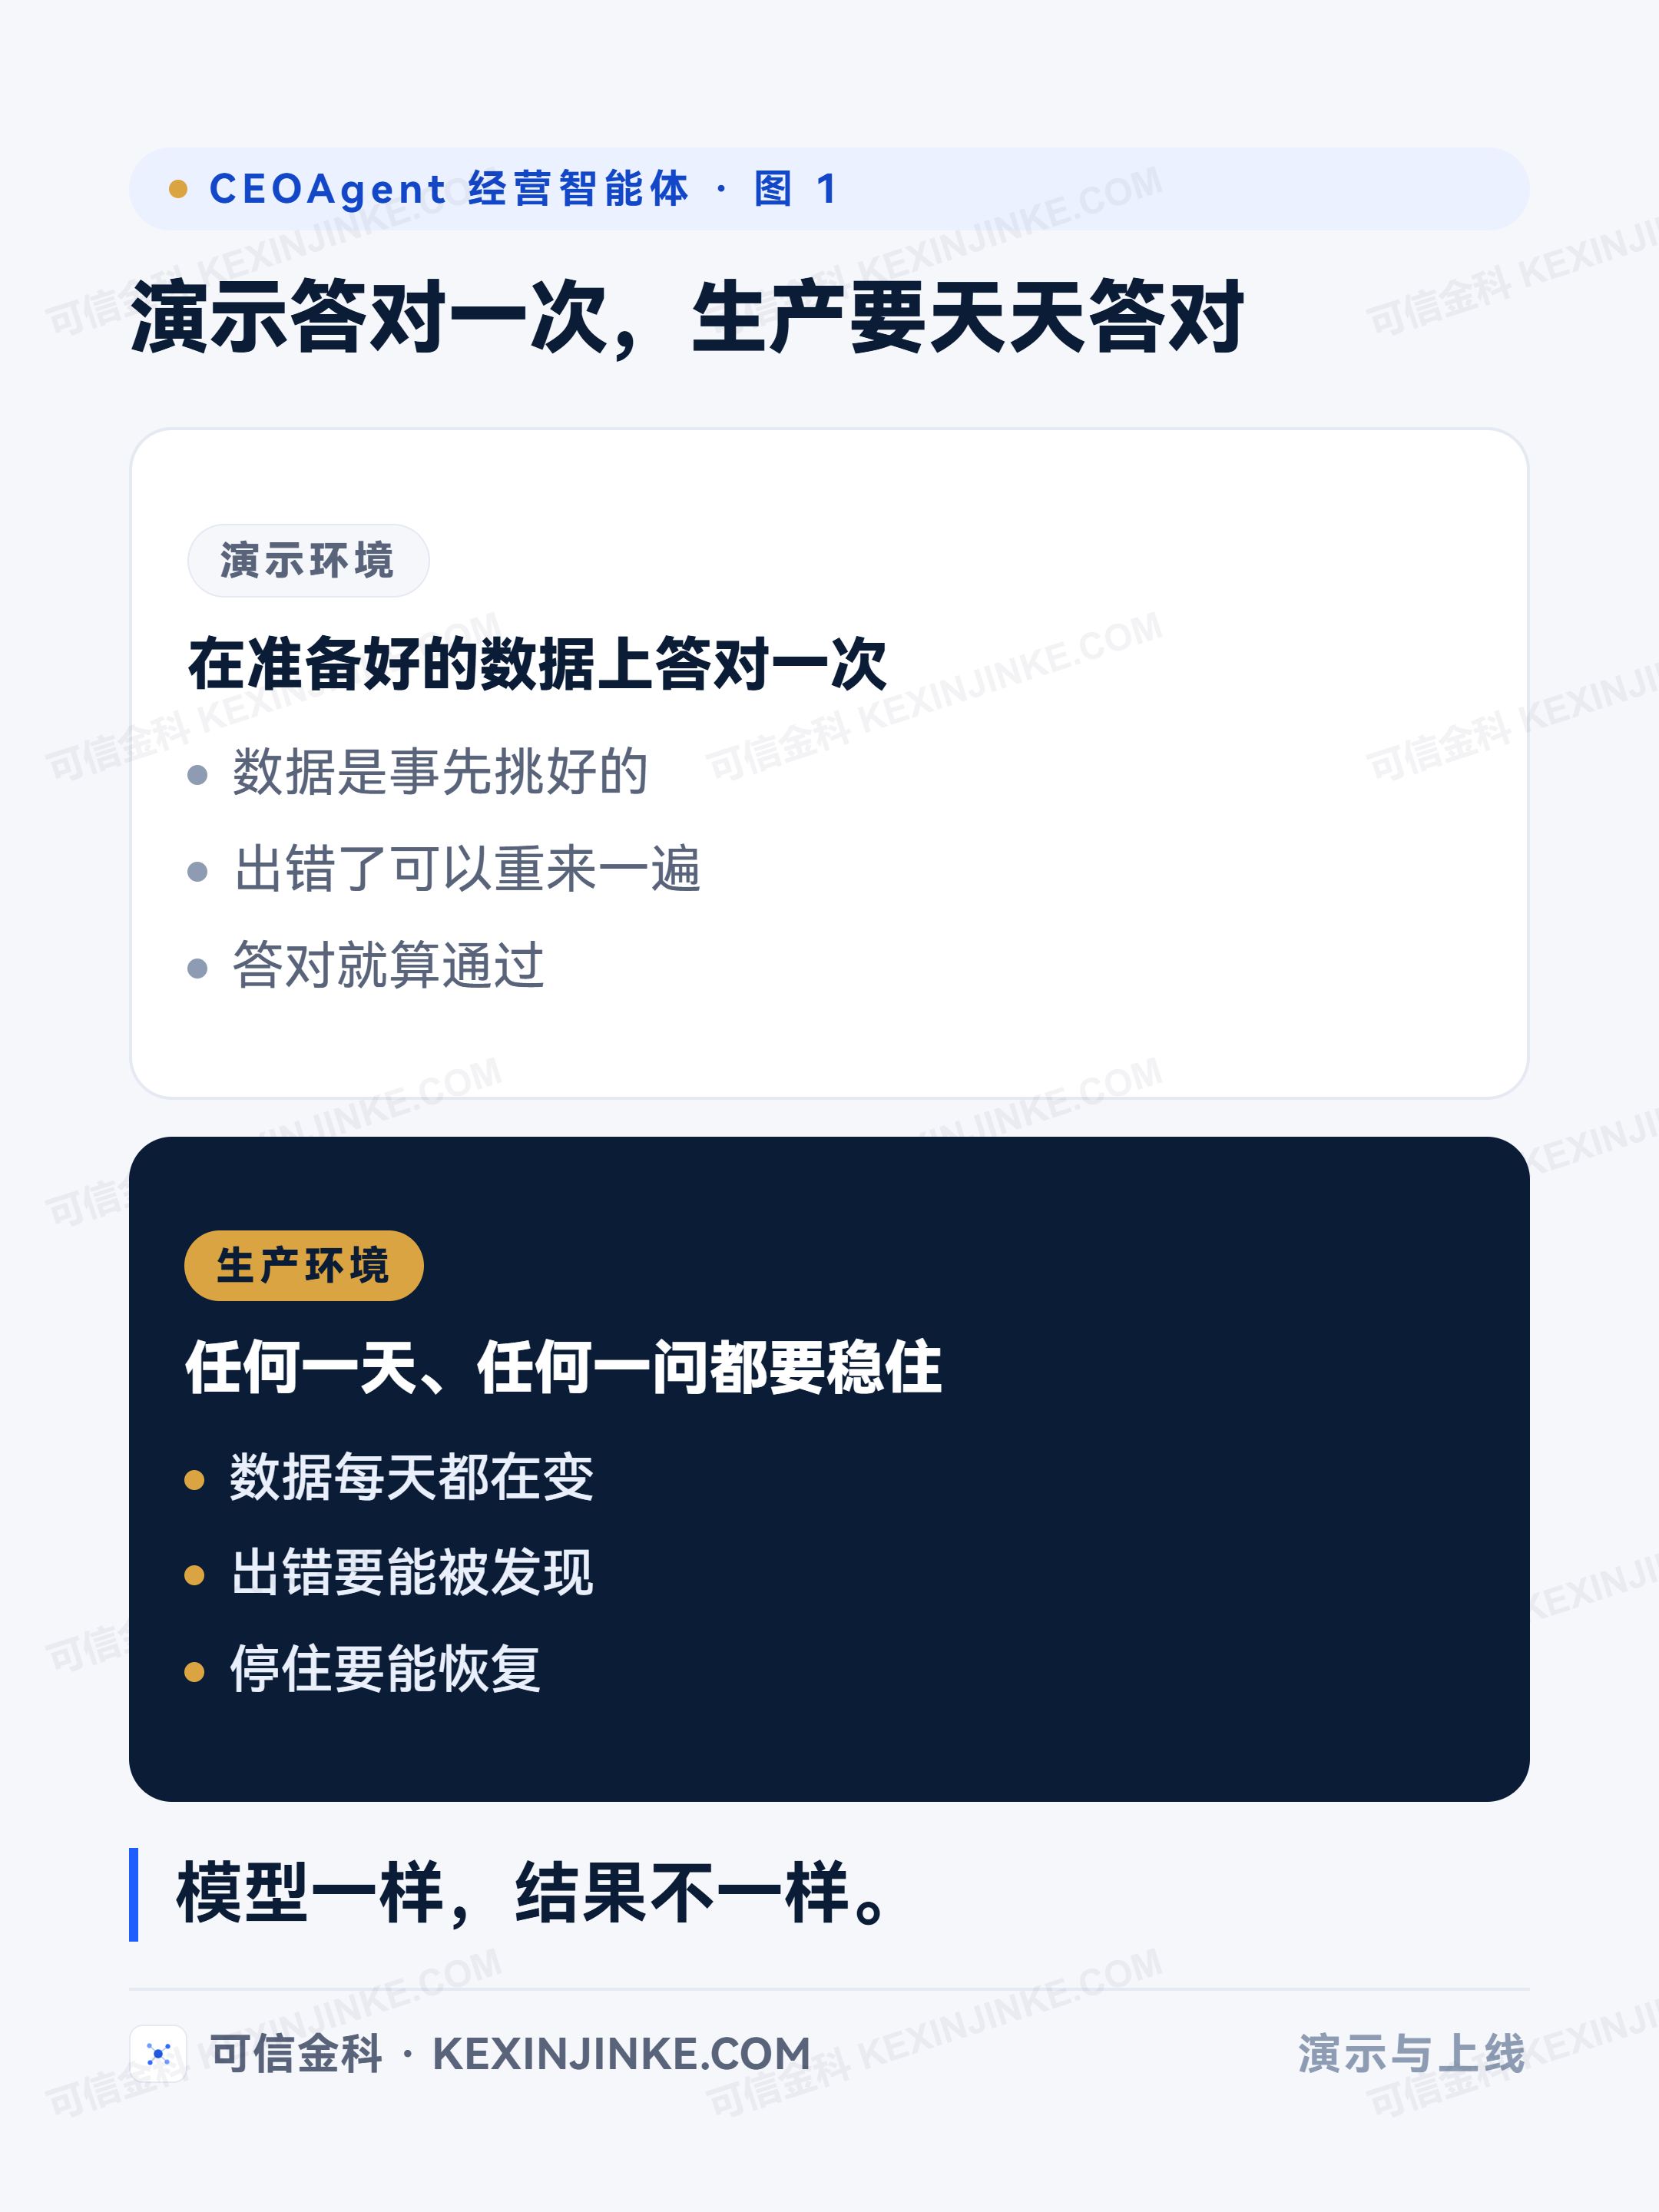
企业上 AI 的路径大同小异:先挑一个场景,接入资料,做出演示,再开一场评审会。会议室里提问顺利、答案完整,项目看起来已经完成了大半。
一旦接进真实流程,问题会换一副样子。有人问到演示稿没覆盖的口径,回答开始变慢;数据源短暂失败,任务停在半路;同一个问题换个人来问,系统没有识别权限差异。有些企业走到这里,几十万元预算已经花掉,项目却停在演示之后。
这类问题很容易被归到模型能力上。可演示只需要答对一次,生产系统要长期运行:数据变了仍能解释,口径不清会停下来问人,出错能被发现,停住以后还能恢复。
业内把承担这段工作的角色称为前线部署工程师(Forward Deployed Engineer,FDE)。OpenAI 对该岗位的职责描述贯穿需求发现、技术定界、系统设计、构建和生产采用;Palantir 则强调工程师与客户并肩工作,并对端到端结果负责。两者指向的是同一件事:项目不能止于交付一个演示,工程工作要延伸到业务现场。
演示和上线之间,差的是一段现场工程
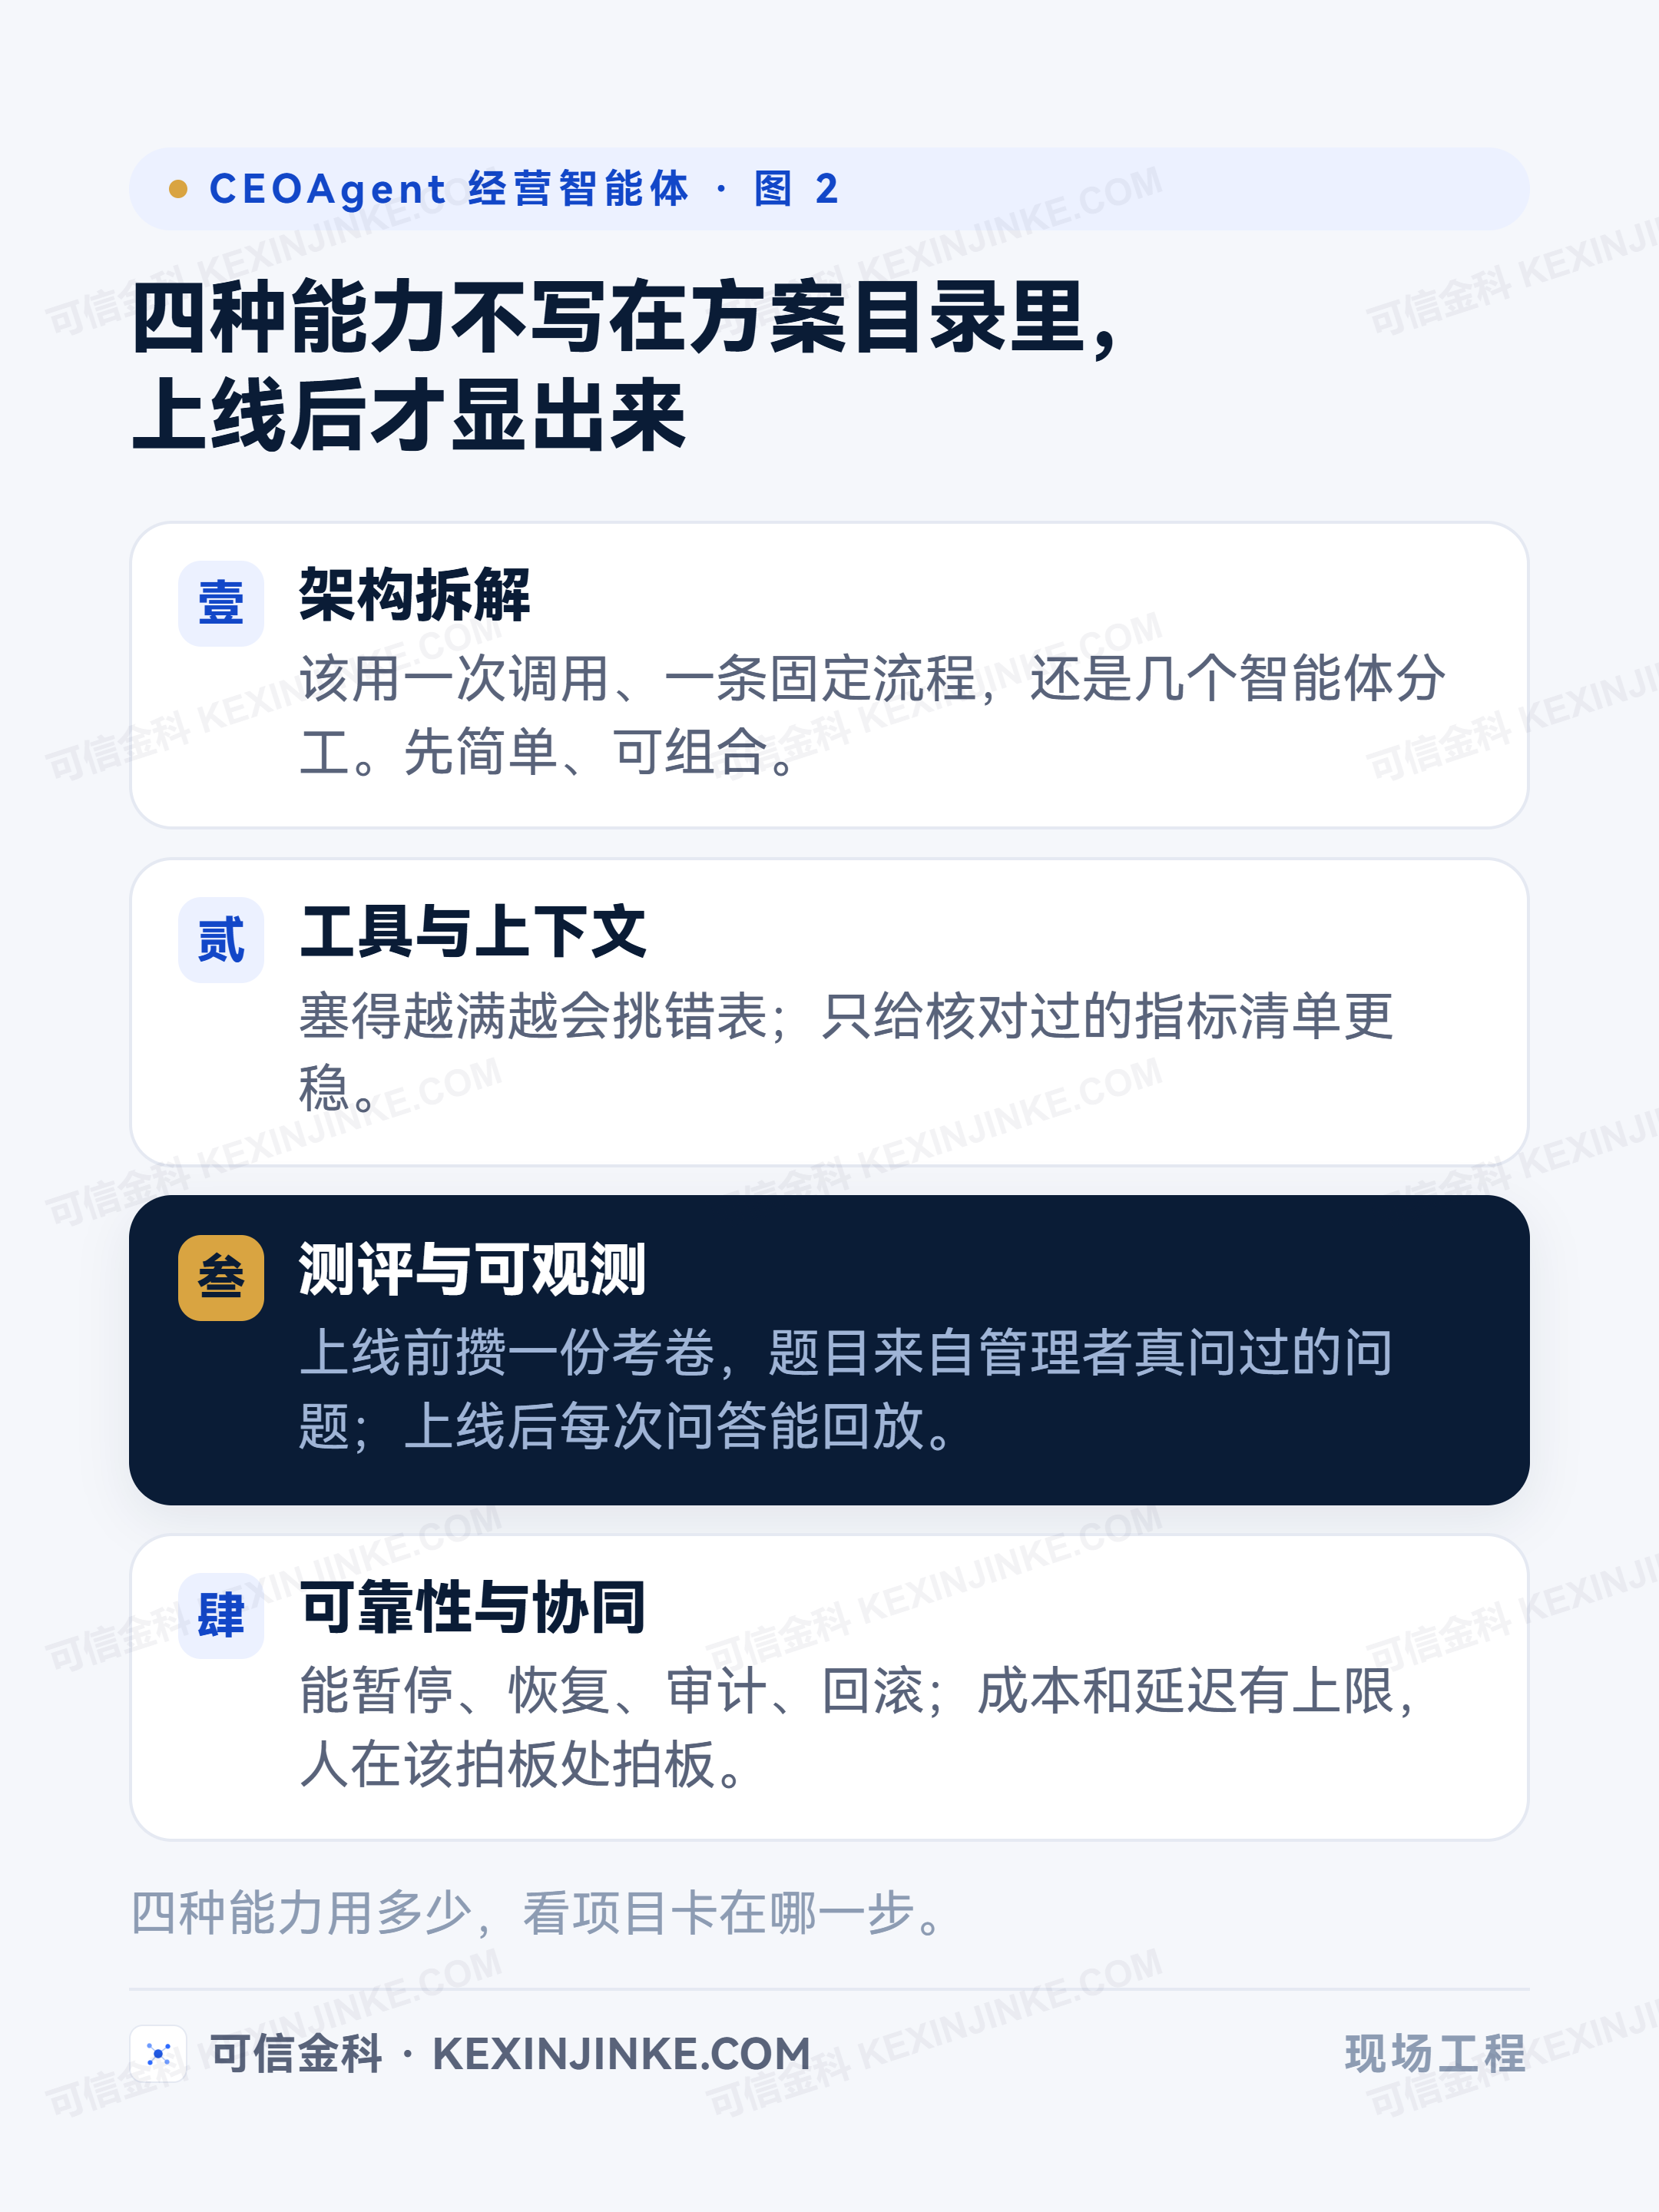
第一项工作是架构拆解。一个需求刚提出来时,团队容易先讨论用什么模型、分几个智能体。更稳妥的顺序是先看流程能否拆开、哪一步必须确定、哪一步允许模型判断。能用一个提示完成的任务先保持简单;需要取数、计算、审批的部分交给程序和规则。即便问题复杂到要排明年现金流,也先用一条固定流程加人工确认,不急着拆成多个智能体。
第二项是工具与上下文工程。模型收到的不能只是聊天记录,还要有这次任务需要的资料、身份权限、指标口径和前序结果。资料不全时,系统应当知道缺什么;拿到数据后,还要区分原始值、计算值和人工确认值。上下文并非越长越好,关键是每次只装入完成当前步骤所需的内容。
第三项是测评与可观测。演示时,团队通常挑熟悉的问题;上线后,员工会换说法、漏条件,也会提出超出范围的问题。验收因此不能只看几道样题。项目需要保留固定考题、预期结果和失败类型,每次改模型、提示或取数逻辑都重新检查。系统还要记录这次用了哪些资料、在哪一步耗时、为什么转人工,否则只能看到“答错了”,却不知道该修哪里。
第四项是生产可靠性与人机协同。真实系统会遇到接口超时、数据缺失、权限不足和口径冲突。每种异常都要有去向:重试、换用已确认数据、返回上一步,或交给负责人处理。口径拿不准,系统停下来问人,并把这次确认记下来留到下次用。人工节点不是项目失败的标志,它让系统知道哪些判断不能自行越过。
四种能力的投入比例不会固定。数据分散的项目,工具与上下文工程更重;业务责任复杂的项目,人工确认和留痕更重。评审时应先问项目卡在哪一步,再决定工程力量放在哪里。
企业里还有第五种能力,排在四种之前
企业报表和业务系统不能原样交给大模型。表里的字段名、统计范围、更新频率和责任部门,往往只有长期使用它们的人才明白。第五种能力,就是把这些业务语义翻译成模型能够选择、程序能够执行的语言。
这层翻译可以分为三层。最下面是业务域,例如销售、成本、资金和项目进度;中间是经过确认的指标,写清名称、口径、来源和截止时间;最上面是提供给模型的菜单,只说明什么问题可选什么指标,不暴露原始表格和计算细节。
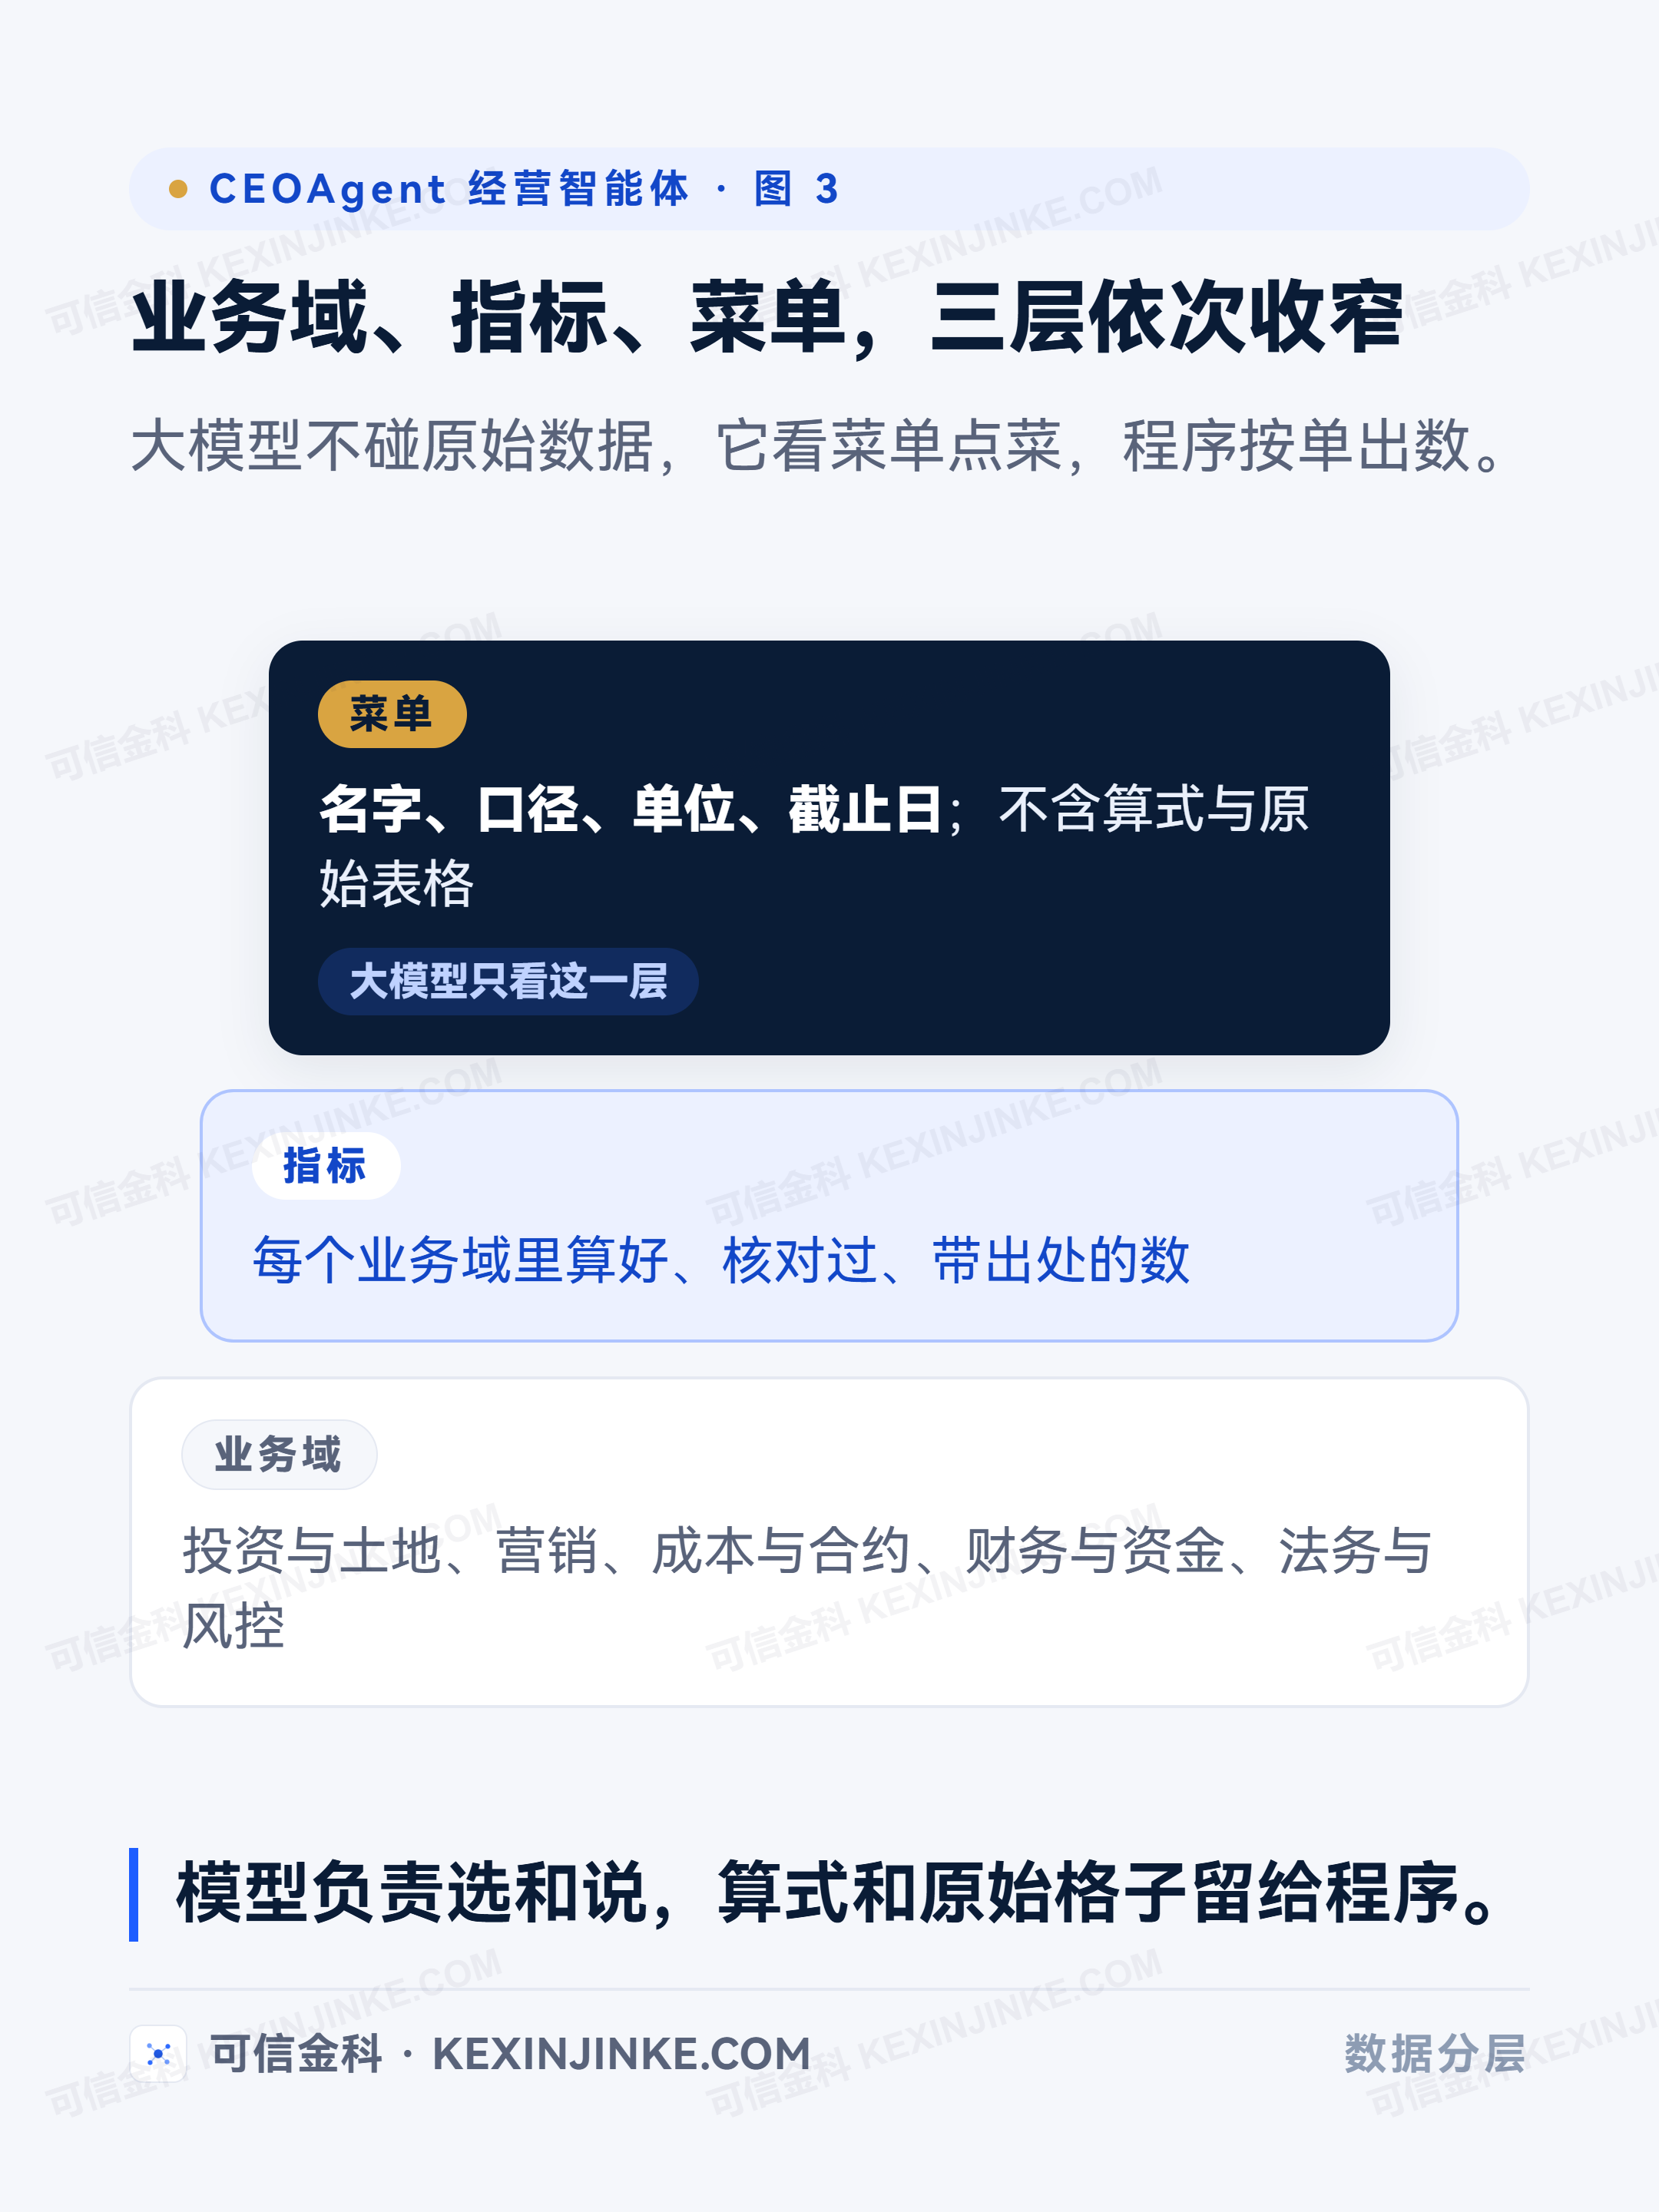
用户提问后,模型先从菜单中挑选指标,程序再按指标定义取数和计算。模型负责理解问题与组织回答,每个数字由确定的程序生成,并带上来源。这样做的价值不只在准确:业务负责人可以修改指标口径,技术人员可以检查取数过程,模型升级也不必重写底层计算。
一个经营智能体项目的问题路径
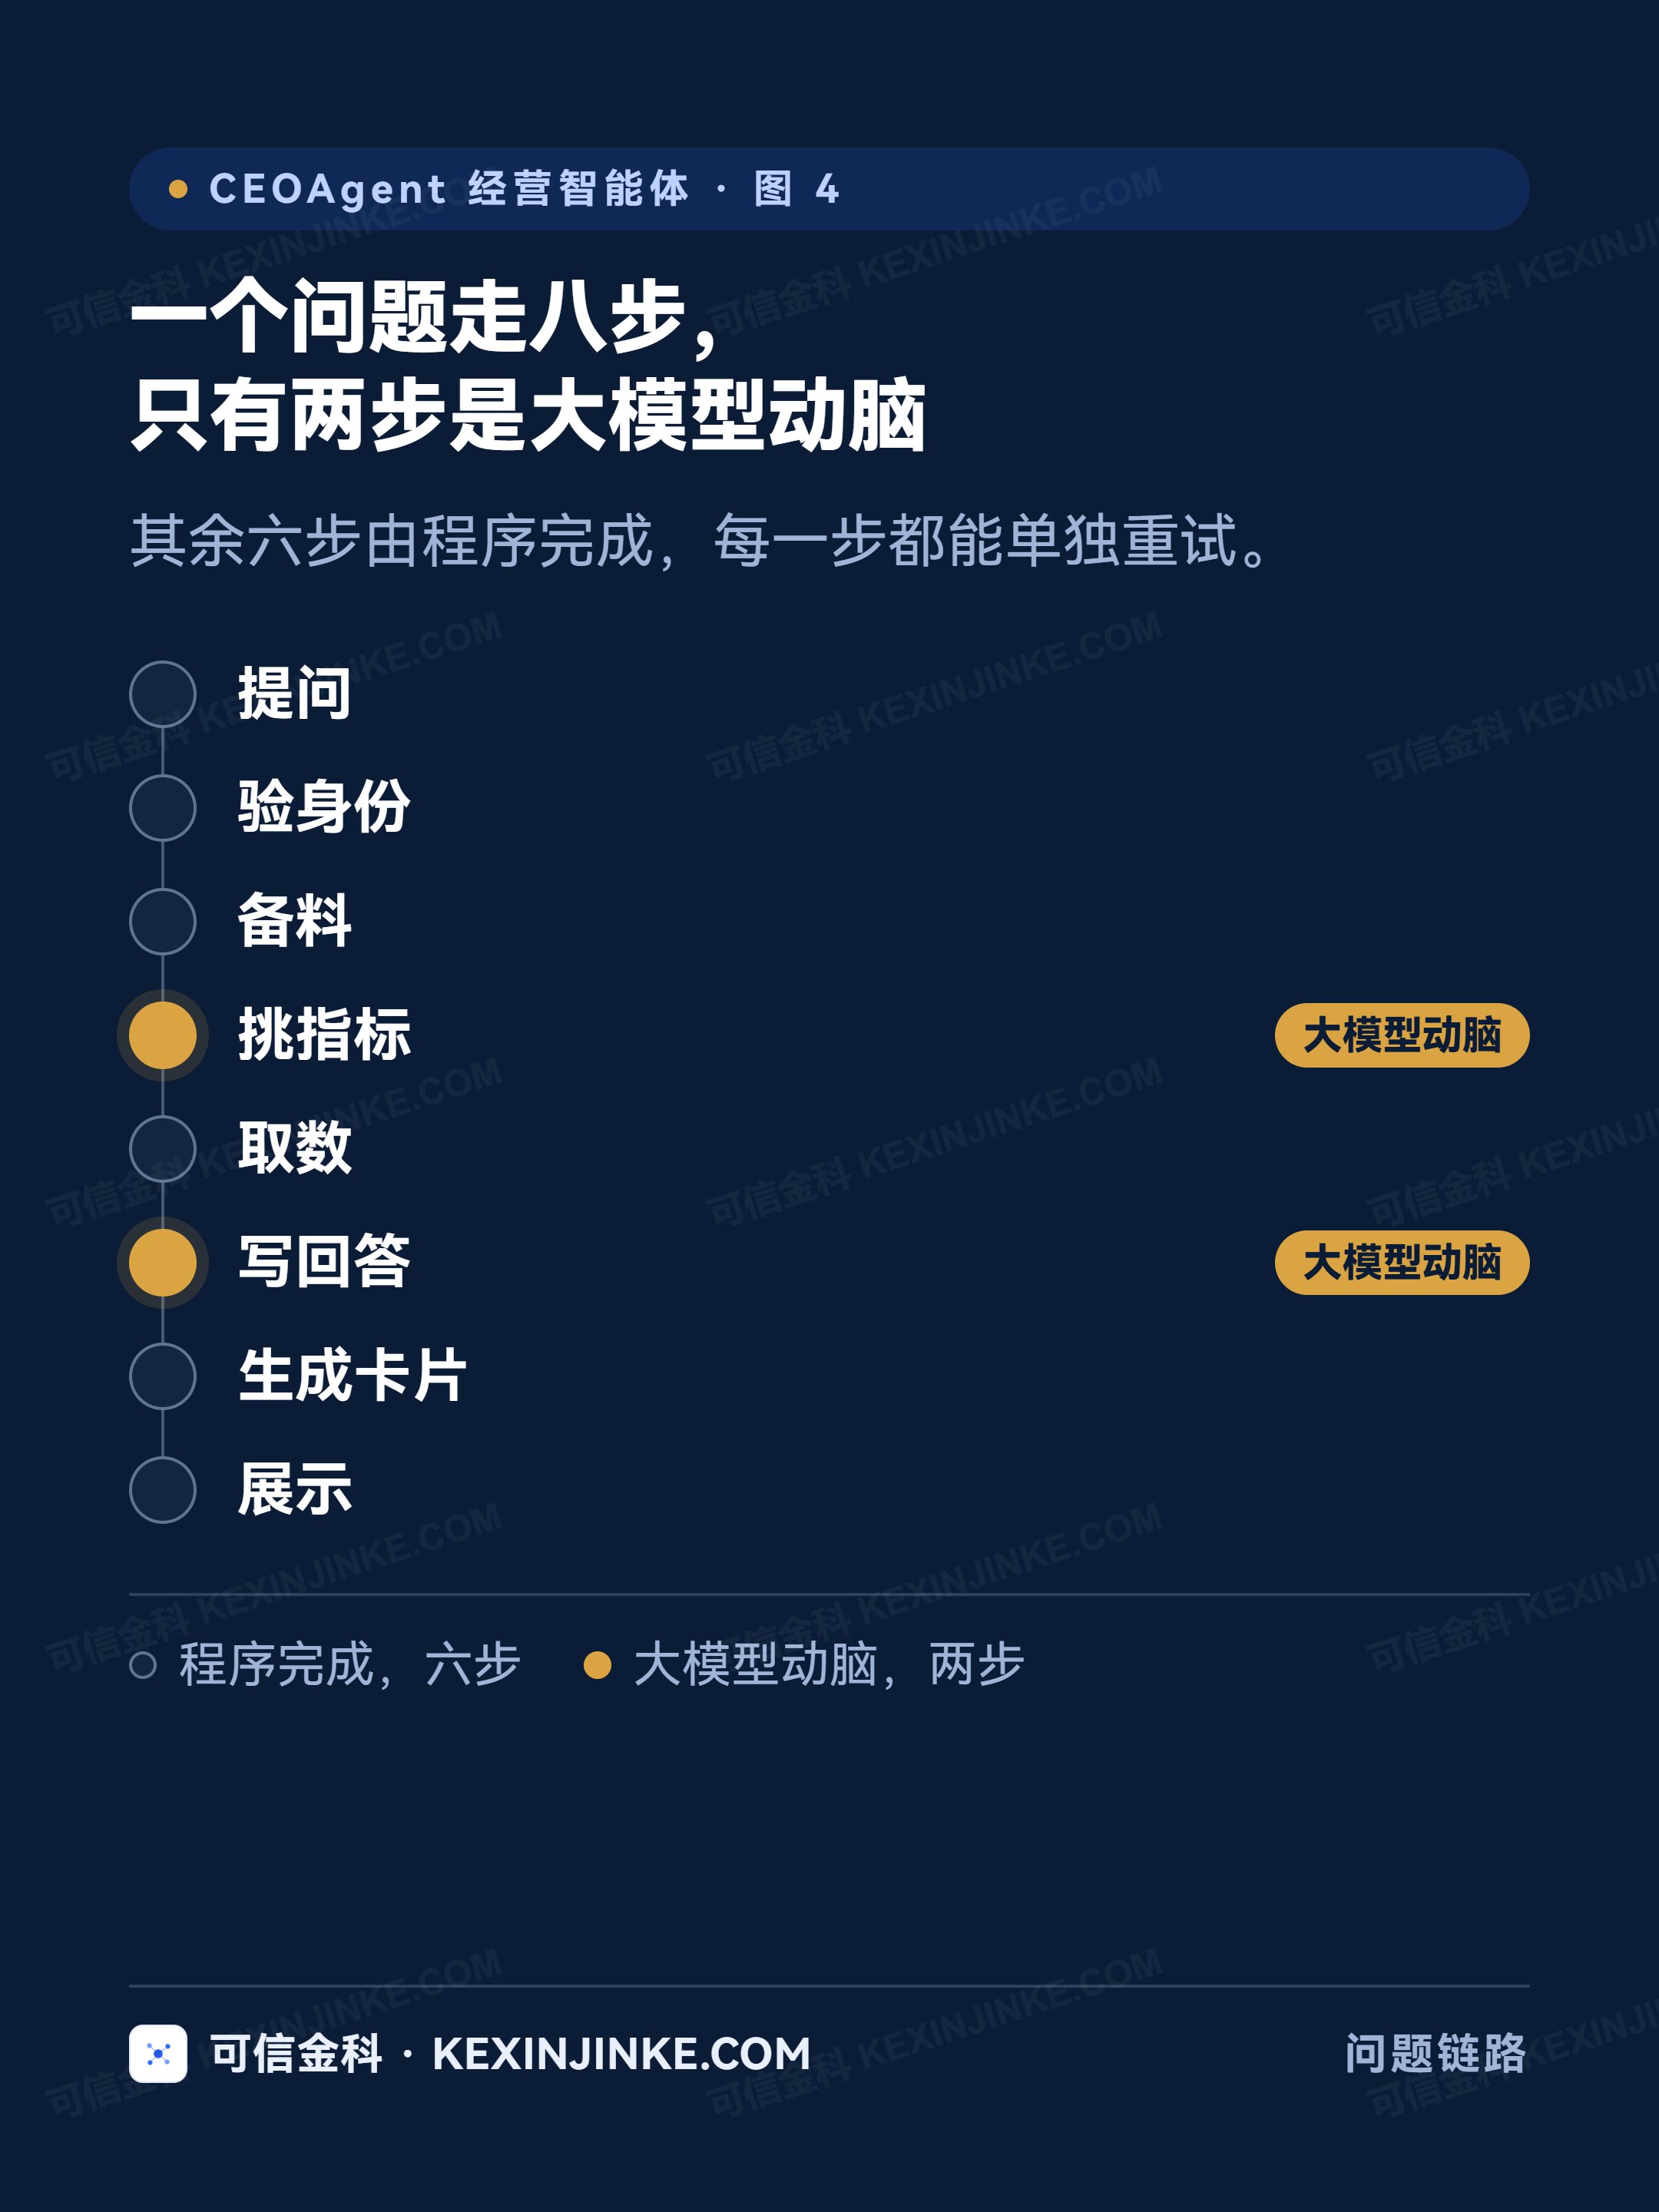
以一个房地产开发集团经营智能体项目的类型化流程为例,管理者问出一个问题后,系统并不是立刻把整包数据交给模型。一次回答要走八步:接收提问、核验身份、准备资料、挑选指标、执行取数、组织回答、生成卡片、展示结果。
这八步中,只有挑指标和写回答需要大模型判断。身份核验由权限系统完成,资料准备与取数由程序执行,卡片生成遵循固定格式。职责拆开以后,答案出了问题,可以判断是权限、口径、数据、计算还是表达出了错,不必把所有故障都归给模型。
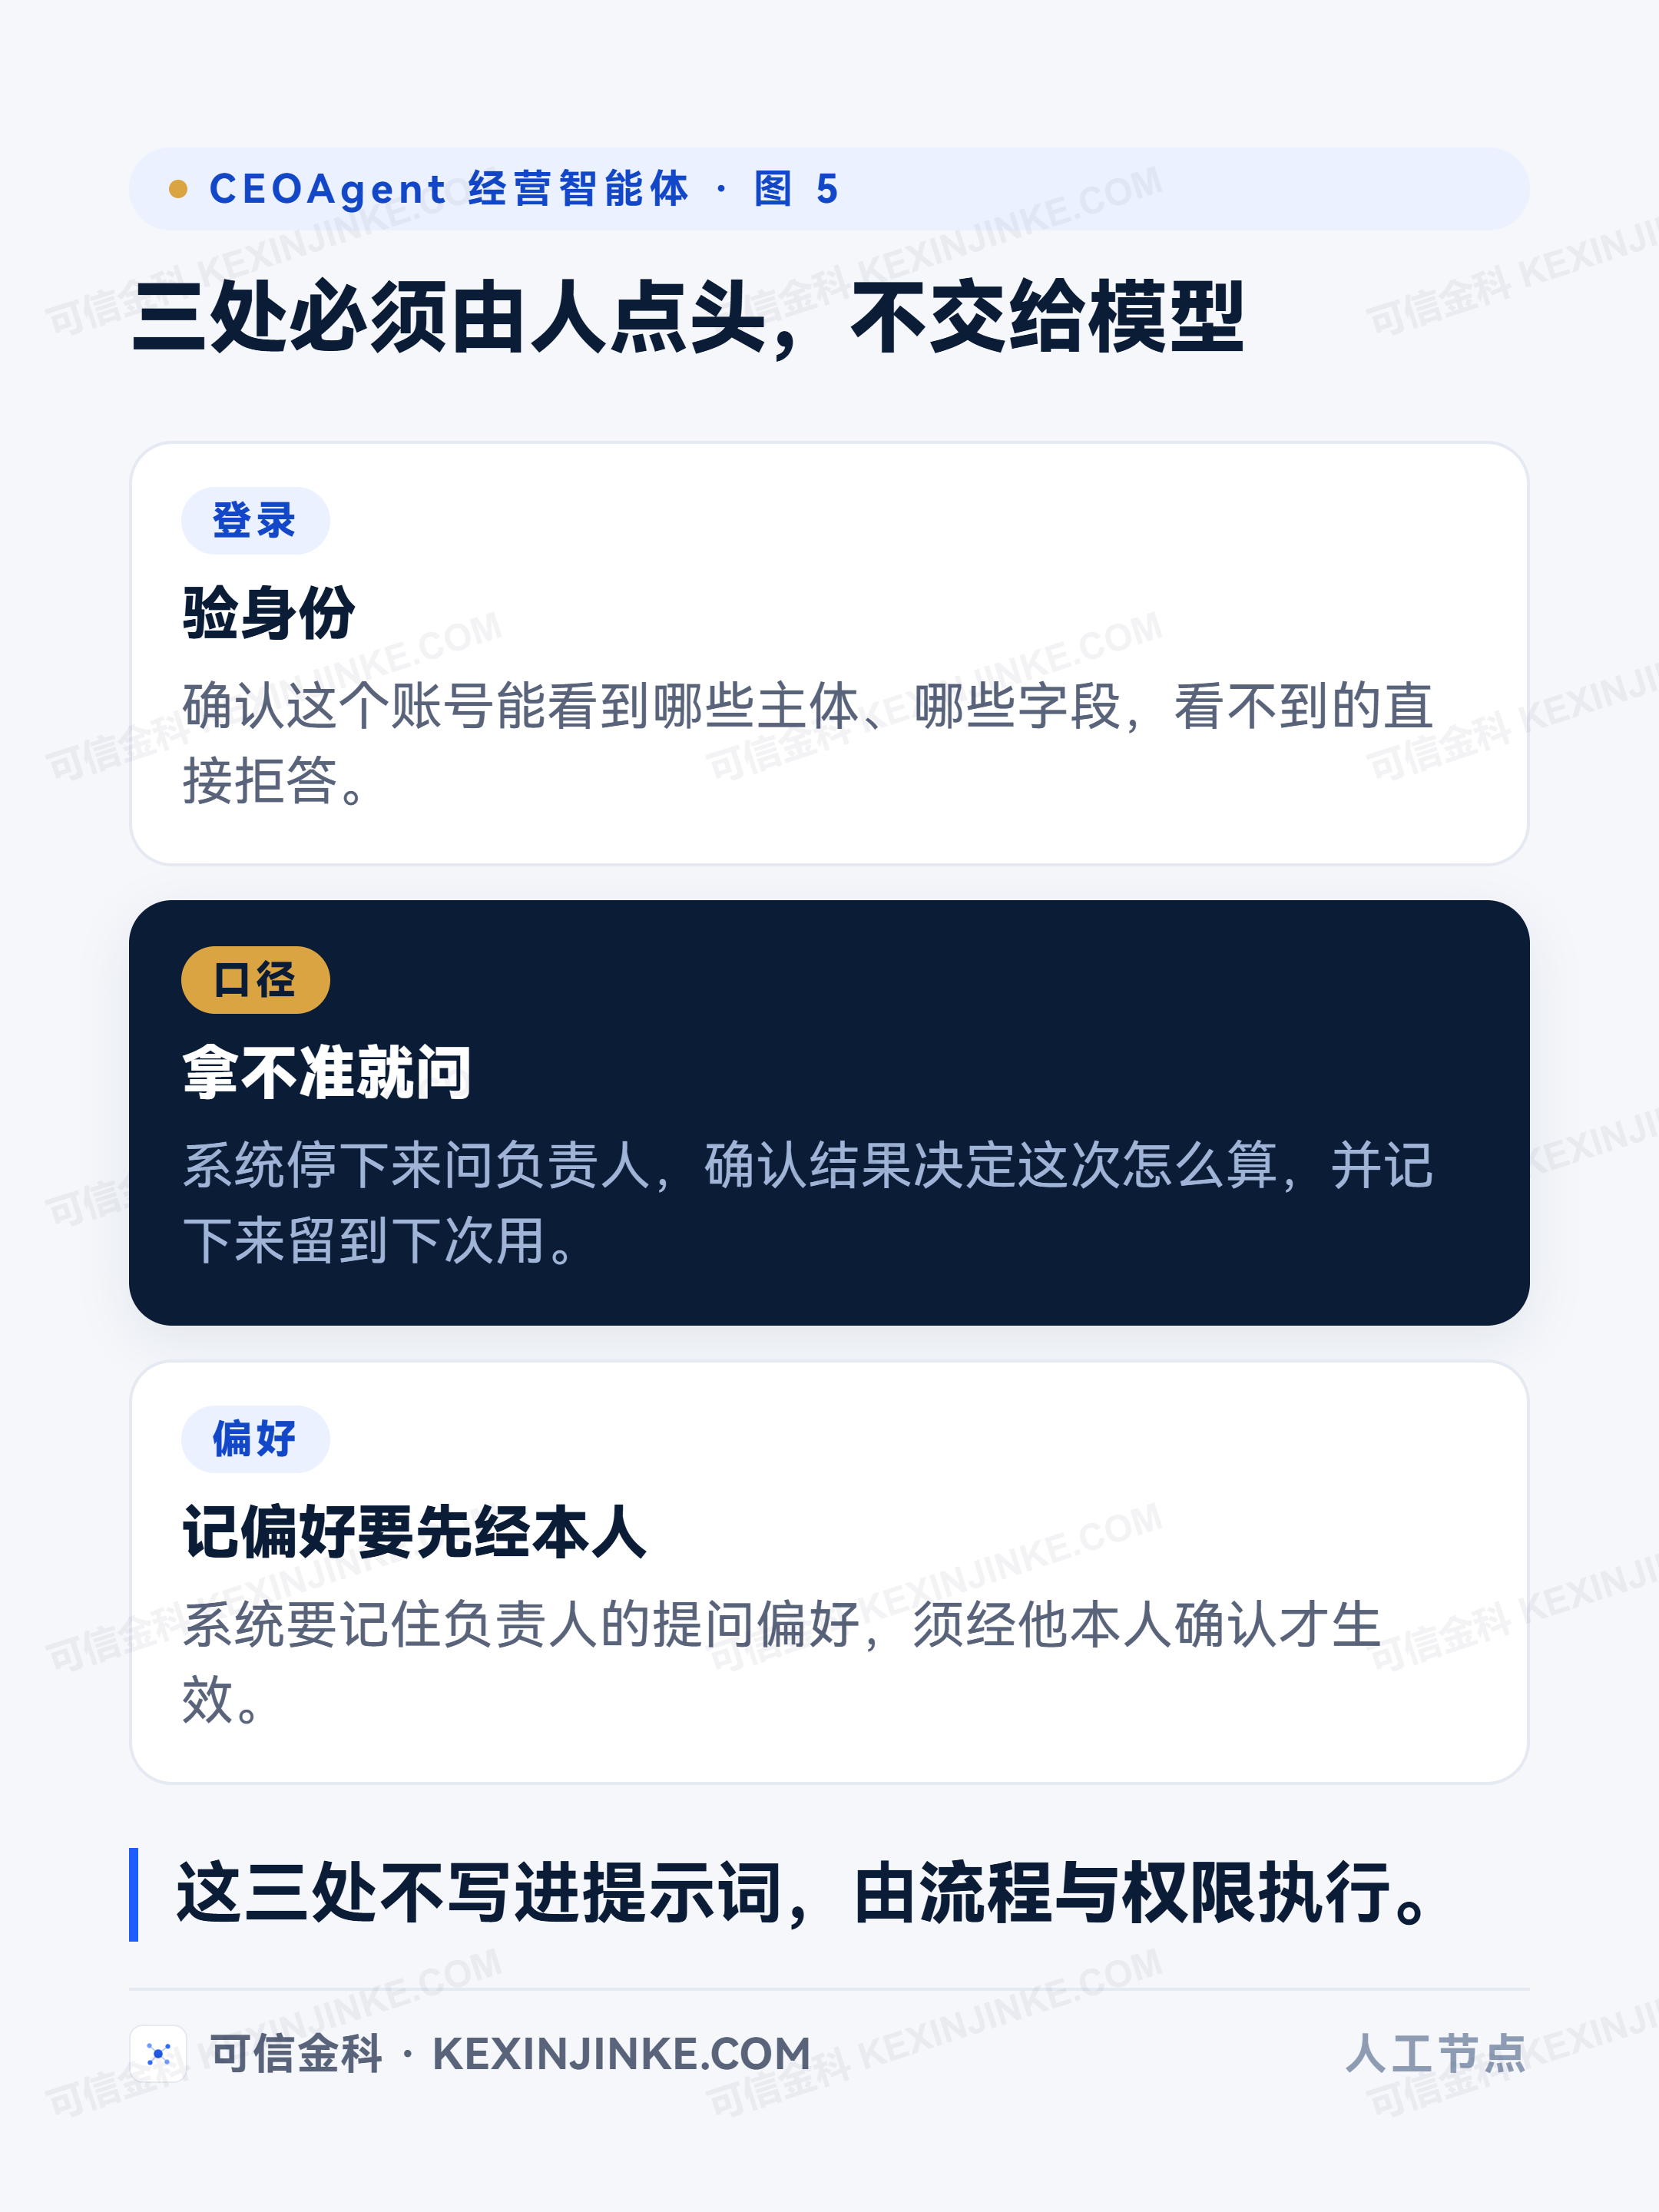
人在这条路径上有三处必须点头。登录时先确认提问者身份,决定他能看哪些项目和指标;指标口径有分歧时,请对应负责人确认;系统准备记住个人偏好前,先取得本人同意。三处人工节点分别守住权限、业务责任和个人选择,不能用一句“模型自行判断”带过。
这条问题路径也给出了验收办法。每一步都应有明确输入、输出和失败处理;需要人工确认时,页面应说明在等谁、等什么。只看最终答案,会漏掉生产系统最重要的部分:任务能否被接住、被检查,并在异常后继续运行。
判断 AI 供应商靠不靠谱,看三件事
评审会上不必从模型参数问起。先让供应商拿出一张状态图,标明任务从哪一步开始,成功后走向哪里,失败后从哪一步恢复。只有顺向流程、没有失败路径的图,通常仍是演示流程。
再看轨迹。任意挑一次问答,应当能查到谁在什么时间提出问题、系统选择了哪些指标、调用了哪些资料、在哪些节点等待人工确认。轨迹不是堆一页技术日志,而是让业务、技术和审计人员都能找到自己要核对的记录。
最后看出处。答案里的结论和数字应当能够点回来源,至少说明源系统、数据截止时间和所用口径。出现多源不一致时,页面要把差异摆出来,不能自行取一个看似合理的结果。经营决策智能体的数据可信问题 最终都落在这一点上。
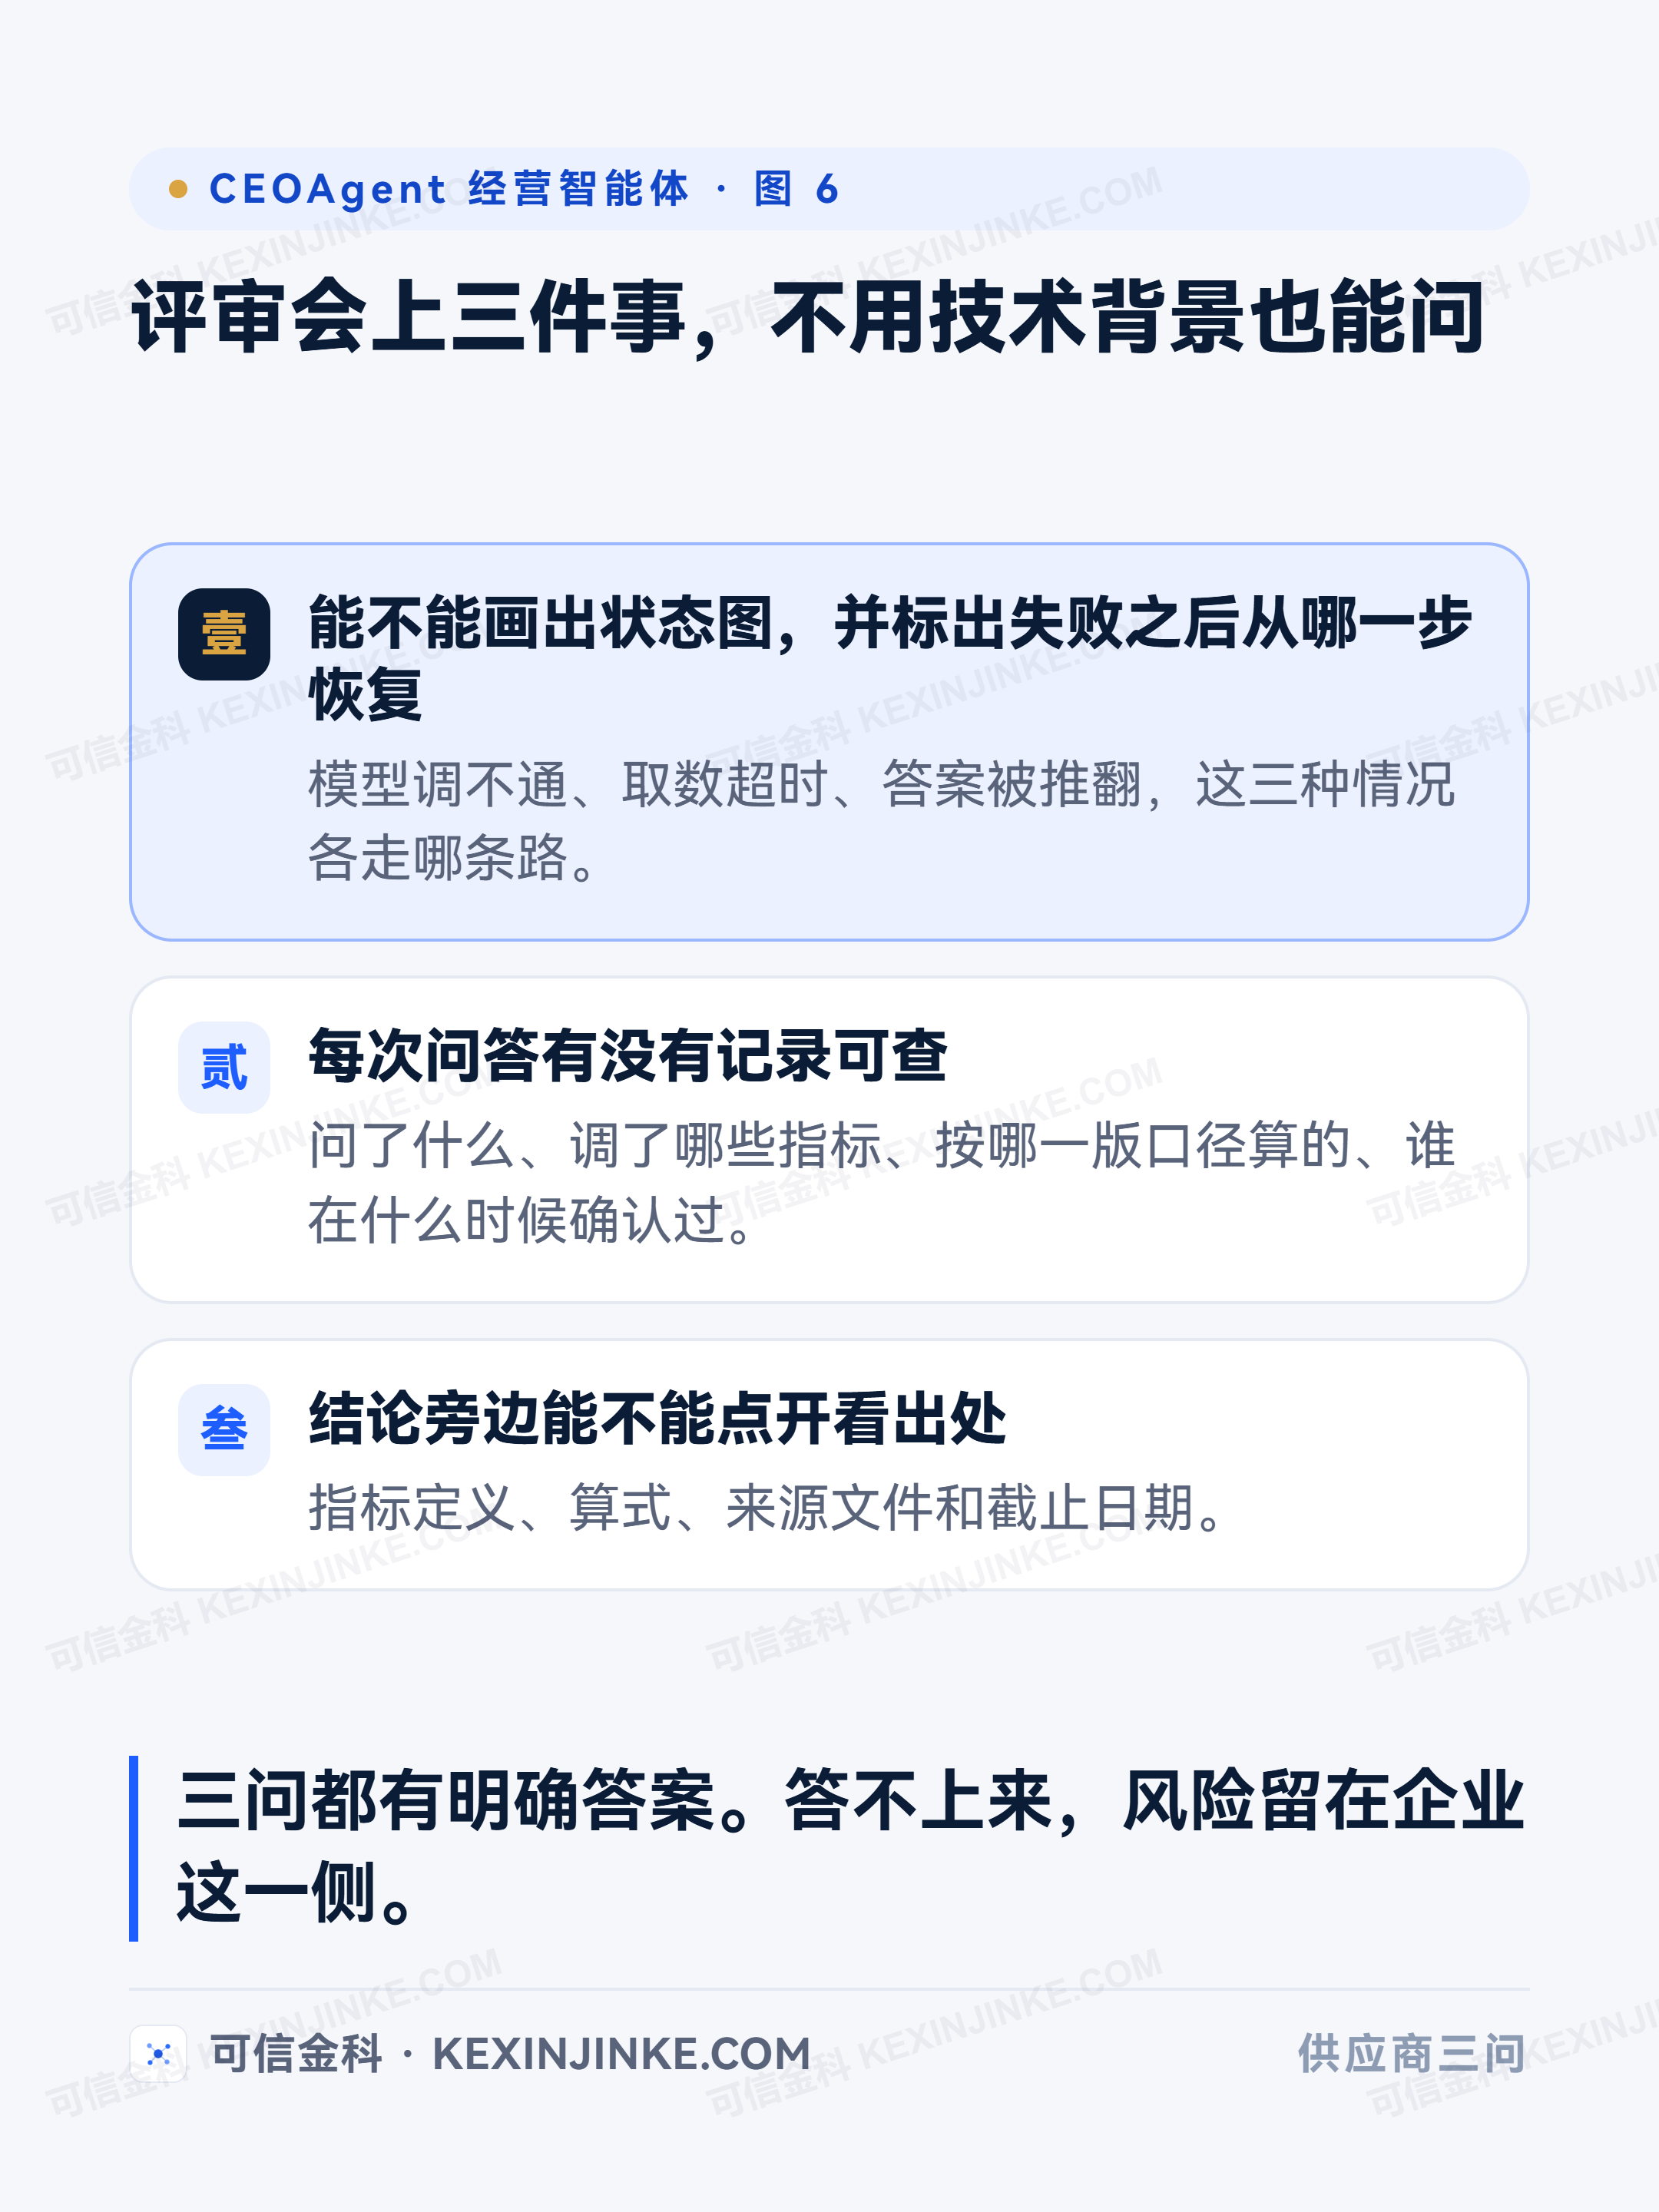
这三件事同时具备,才说明供应商考虑过系统怎样运行、怎样查错,以及结论怎样被复核。演示回答得漂亮只能证明模型在一个时点可用;能把失败路径、运行轨迹和证据出处交出来,项目才有进入生产流程的基础。
可信金科把企业经营数据接入大模型,形成与企业既有业务系统和固定看板并行工作的 CEOAgent。产品已上线,首批客户正在使用;项目由前线部署工程师进入现场,完成数据、口径、权限、评测和运行流程的衔接。